
Competencias propuestas para desarrollar en el estudiante para la materia de Base d datos avanzados
Elabora un diseño conceptual de una base de datos
Empleando el modelo entidad relación con un máximo de 7 entidades
Utilizado comunicación continua y efectiva con el usuario en el diseño conceptual de la base de datos
Elabora el diseño lógico de una base de datos con implementación en un sistema gestor de base de datos
Utilizando herramientas o instrumentos de diseño
Genera consultas
Utilizando un lenguaje de consultas estructurada
Administra una base de datos
Utilizando un SMBD
Actualizando datos y estructura de la BD, depurando registros
Genera consultas
Olivier, H. (2009). PHP y MySQL Domine el desarrollo de un sitio Web dinámico e interactivo. Ediciones ENI. Capítulo 2.
Administra una base de datos
Mike, H. (2009). SQL Server 2008. Grupo Anaya Comercial.
Helma, S. (2010). Programación de Base de Datos Con MySQL y PHP. Alfaomega Marcombo.
Elabora un diseño conceptual de una base de datos
Empleando el modelo entidad relación con un máximo de 7 entidades
Utilizado comunicación continua y efectiva con el usuario en el diseño conceptual de la base de datos
Elabora el diseño lógico de una base de datos con implementación en un sistema gestor de base de datos
Utilizando herramientas o instrumentos de diseño
Genera consultas
Utilizando un lenguaje de consultas estructurada
Administra una base de datos
Utilizando un SMBD
Actualizando datos y estructura de la BD, depurando registros
Genera consultas
Olivier, H. (2009). PHP y MySQL Domine el desarrollo de un sitio Web dinámico e interactivo. Ediciones ENI. Capítulo 2.
Administra una base de datos
Mike, H. (2009). SQL Server 2008. Grupo Anaya Comercial.
Helma, S. (2010). Programación de Base de Datos Con MySQL y PHP. Alfaomega Marcombo.
Relación de Base de datos avanzados con otras asignaturas:
• Expresividad: cuantos más mecanismos o conceptos de
representación tenga un modelo mayor será la cantidad de propiedades
del sistema de información que pueda captar, y menor el uso de
aserciones en forma de restricciones de integridad que no se pueden
reflejar directamente sobre el esquema. •Simplicidad: también es deseable que el modelo sea simple para que
los esquemas sean fáciles de entender por terceras personas. Debe
llegarse, pues, a un equilibrio entre la potencia del modelo mencionada
en el punto anterior y esa simplicidad deseable.
• Minimalidad: cada concepto tiene un significado distinto de los demás
conceptos utilizados en el modelo de datos; no se puede expresar un
concepto en función de otros.
• Formalidad: todos los conceptos del modelo tienen una interpretación
única, precisa y bien definida. Puesto que el esquema pretende ser una
especificación formal del sistema de información a representar, esta
cualidad permitiría el tratamiento matemático de sus conceptos.
Si el modelo utiliza un lenguaje de definición gráfico, también tendremos en
cuenta:
• Compleción gráfica: un modelo es gráficamente completo si todos sus
conceptos poseen representación gráfica.
• Facilidad de lectura: que los símbolos gráficos sean fácilmente
distinguibles unos de otros.
II5. Clasificación de modelos
Estructura conceptual de la materia de base de datos avanzados:

Historia de Base de datos avanzadas
En las últimas décadas, ha surgido una
noción más sofisticada de las bases de datos. Por un lado, el objetivo de
servir a las necesidades operacionales, y por otro, cubrir las necesidades
analíticas de la información.

Las tablas de dispersión, más conocidas como tablas hash, son unas de las estructuras de datos más frecuentemente usadas. Para tener una idea inicial, las tablas de dispersión posibilitan tener una estructura que relaciona una clave con un valor, como un diccionario. Internamente, las tablas de dispersión son un array. Cada una de las posiciones del array puede contener ninguna, una o varias entradas del diccionario. Normalmente contendrá una como máximo, lo que permite un acceso rápido a los elementos, evitando realizar una búsqueda en la mayoría de los casos. Para saber en qué posición del array se debe buscar o insertar una clave, se utiliza una función de dispersión. Una función de dispersión relaciona a cada clave con un valor entero. Dos claves iguales deben tener el mismo valor de dispersión, también llamado hash value, pero dos claves distintas pueden tener el mismo valor de dispersión, lo cual provocaría una colisión.
El valor de dispersión es un entero sin signo entre 0 y el máximo entero de la plataforma, por lo que la tabla de dispersión usa el resto de dividir el valor de dispersión entre el tamaño del array para encontrar la posición. Cuando dos claves tienen que ser almacenadas en la misma posición de la tabla se produce una colisión. Esto puede ser debido a que la función de dispersión no distribuye las claves lo suficiente, o a que hay más claves en la tabla hashque el tamaño del array. En el segundo caso, GLib™ se encargará de redimensionar el array de forma automática.
Para aclarar los conceptos, se examinará el siguiente ejemplo a lo largo de todo el capítulo con el fin de facilitar la comprensión del mismo. Póngase que se desea tener una relación de la información de los activistas de GNOME. Para ello se usará una tabla de dispersión usando como clave el apodo que usa cada desarrollador dentro del proyecto. Y como valor una relación de sus datos personales. Esta relación de datos personales vendría dada por la siguiente estructura.
PROGRAMA PARA LA ASIGNATURA DE BASE DE BATOS AVANZADOS
INTRODUCCIÓN
1.1. APLICACIONES DE LOS SISTEMAS DE BASES DE DATOS
1.2. SISTEMAS DE BASES DE DATOS FRENTE A SISTEMAS DE ARCHIVOS
1.3. VISIÓN DE LOS DATOS
1.4. MODELOS DE LOS DATOS
1.5 LENGUAJES DE BASES DE DATOS
1.6. USUARIOS YADMINISTRADORES DE LA BASE DE DATOS
1.7. GESTIÓN DE TRANSACCIONES
1.8. ESTRUCTURA DE UN SISTEMA DE BASES DE DATOS
1.9. ARQUITECTURAS DE APLICACIONES
1.10. HISTORIA DE LOS SISTEMAS DE BASES DE DATOS
MODELO ENTIDAD-RELACIÓN
2.1. CONCEPTOS BÁSICOS,
2.2. RESTRICCIONES,
2.3. CLAVES,
2.4. CUESTIONES DE DISEÑO,
2.5. DIAGRAMA ENTIDAD-RELACIÓN,
2.6. CONJUNTOS DE ENTIDADES DÉBILES,
2.7. CARACTERÍSTICAS DEL MODELO E-R EXTENDIDO,
2.8. DISEÑO DE UN ESQUEMA DE BASE DE DATOS E-R,
2.9. REDUCCIÓN DE UN ESQUEMA E-R ATABLAS,
2.10. EL LENGUAJE DE MODELADO UNIFICADO UML,
EL MODELO RELACIONAL
3.1. LA ESTRUCTURA DE LAS BASES DE DATOS RELACIONALES,
3.2. EL ÁLGEBRA RELACIONAL,
3.3. OPERACIONES DEL ÁLGEBRA RELACIONAL EXTENDIDA,
3.4. MODIFICACIÓN DE LA BASE DE DATOS,
3.5. VISTAS,
3.6. EL CÁLCULO RELACIONAL DE TUPLAS,
3.7. EL CÁLCULO RELACIONAL DE DOMINIOS,
SQL
4.1. INTRODUCCIÓN,
4.2. ESTRUCTURA BÁSICA,
4.3. OPERACIONES SOBRE CONJUNTOS
4.4. FUNCIONES DE AGREGACIÓN
4.5. VALORES NULOS
4.6. SUBCONSULTAS ANIDADAS
4.7. VISTAS
4.8. CONSULTAS COMPLEJAS,
4.9. MODIFICACIÓN DE LA BASE DE DATOS
OTROS LENGUAJES RELACIONALES
5.1. QUERY-BY-EXAMPLE
5.2. DATALOG
5.3. INTERFACES DE USUARIO Y HERRAMIENTAS
5.4. RESTRICCIONES DE LOS DOMINIOS
5.5. INTEGRIDAD REFERENCIAL

APLICACIONES DE LOS SISTEMAS DE BASES DE DATOS
Las bases de datos son ampliamente usadas. Las siguientes
son algunas de sus aplicaciones más representativas:
• Banca. Para información de los clientes, cuentas
y préstamos, y transacciones bancarias.
• Líneas aéreas. Para reservas e información de planificación.
Las líneas aéreas fueron de los primeros
en usar las bases de datos de forma distribuida
geográficamente (los terminales situados en
todo el mundo accedían al sistema de bases de
datos centralizado a través de las líneas telefónicas
y otras redes de datos).
• Universidades. Para información de los estudiantes,
matrículas de las asignaturas y cursos.
• Transacciones de tarjetas de crédito. Para compras
con tarjeta de crédito y generación mensual
de extractos.
• Telecomunicaciones. Para guardar un registro de
las llamadas realizadas, generación mensual de
facturas, manteniendo el saldo de las tarjetas telefónicas
de prepago y para almacenar información
sobre las redes de comunicaciones.
• Finanzas. Para almacenar información sobre grandes
empresas, ventas y compras de documentos
formales financieros, como bolsa y bonos.
• Ventas. Para información de clientes, productos y
compras.
• Producción. Para la gestión de la cadena de producción
y para el seguimiento de la producción de
elementos en las factorías, inventarios de elementos
en almacenes y pedidos de elementos.
• Recursos humanos. Para información sobre los empleados,
salarios, impuestos y beneficios, y para la
generación de las nóminas.
Como esta lista ilustra, las bases de datos forman una
parte esencial de casi todas las empresas actuales.
Alo largo de las últimas cuatro décadas del siglo veinte,
el uso de las bases de datos creció en todas las empresas.
En los primeros días, muy pocas personas interactuaron
directamente con los sistemas de bases de datos,
aunque sin darse cuenta interactuaron con bases de datos
indirectamente (con los informes impresos como extractos
de tarjetas de crédito, o mediante agentes como cajeros
de bancos y agentes de reserva de líneas aéreas). Después
vinieron los cajeros automáticos y permitieron a los
usuarios interactuar con las bases de datos. Las interfaces
telefónicas con los computadores (sistemas de respuesta
vocal interactiva) también permitieron a los usuarios manejar
directamente las bases de datos. Un llamador podía
marcar un número y pulsar teclas del teléfono para introducir
información o para seleccionar opciones alternativas,
para determinar las horas de llegada o salida, por ejemplo,
o para matricularse de asignaturas en una universidad.
La revolución de Internet a finales de la década de
1990 aumentó significativamente el acceso directo de lusuario a las bases de datos. Las organizaciones convirtieron
muchas de sus interfaces telefónicas a las
bases de datos en interfaces Web, y pusieron disponibles
en línea muchos servicios. Por ejemplo, cuando
se accede a una tienda de libros en línea y se busca un
libro o una colección de música se está accediendo a
datos almacenados en una base de datos. Cuando se
solicita un pedido en línea, el pedido se almacena en
una base de datos. Cuando se accede a un banco en un
sitio Web y se consulta el estado de la cuenta y los
movimientos, la información se recupera del sistema
de bases de datos del banco. Cuando se accede a un
sitio Web, la información personal puede ser recuperada
de una base de datos para seleccionar los anuncios
que se deberían mostrar.
Considérese parte de una empresa de cajas de ahorros que
mantiene información acerca de todos los clientes y cuentas
de ahorros. Una manera de mantener la información
en un computador es almacenarla en archivos del sistema
operativo. Para permitir a los usuarios manipular la
información, el sistema tiene un número de programas
de aplicación que manipula los archivos, incluyendo:
• Un programa para efectuar cargos o abonos en una
cuenta.
• Un programa para añadir una cuenta nueva.
• Un programa para calcular el saldo de una cuenta.
• Un programa para generar las operaciones mensuales.
Estos programas de aplicación se han escrito por programadores
de sistemas en respuesta a las necesidades
de la organización bancaria.
Si las necesidades se incrementan, se añaden nuevos
programas de aplicación al sistema. Por ejemplo, supóngase
que las regulaciones de un nuevo gobierno permiten
a las cajas de ahorros ofrecer cuentas corrientes.
Como resultado se crean nuevos archivos permanentes
que contengan información acerca de todas las cuentas
corrientes mantenidas por el banco, y puede ser necesario
escribir nuevos programas de aplicación para tratar
situaciones que no existían en las cuentas de ahorro, tales
como manejar descubiertos. Así, sobre la marcha, se añaden
más archivos y programas de aplicación al sistema.
Este sistema de procesamiento de archivos típico
que se acaba de describir se mantiene mediante un sistema
operativo convencional. Los registros permanentes
son almacenados en varios archivos y se escriben
diferentes programas de aplicación para extraer registros
y para añadir registros a los archivos adecuados.
Antes de la llegada de los sistemas de gestión de bases
de datos (SGBDs), las organizaciones normalmente han
almacenado la información usando tales sistemas.
los accesos Web pueden ser almacenados en una base
de datos.
Así, aunque las interfaces de datos ocultan detalles
del acceso a las bases de datos, y la mayoría de la gente
ni siquiera es consciente de que están interactuando
con una base de datos, el acceso a las bases de datos forma
una parte esencial de la vida de casi todas las personas
actualmente.
La importancia de los sistemas de bases de datos se
puede juzgar de otra forma: actualmente, los vendedores
de sistemas de bases de datos como Oracle están
entre las mayores compañías software en el mundo, y
los sistemas de bases de datos forman una parte importante
de la línea de productos de compañías más diversificadas,
como Microsoft e IBM.
Mantener información de la organización en un sistema
de procesamiento de archivos tiene una serie de
inconvenientes importantes:
• Redundancia e inconsistencia de datos. Debido
a que los archivos y programas de aplicación son
creados por diferentes programadores en un largo
período de tiempo, los diversos archivos tienen probablemente
diferentes formatos y los programas
pueden estar escritos en diferentes lenguajes. Más
aún, la misma información puede estar duplicada
en diferentes lugares (archivos). Por ejemplo, la
dirección y número de teléfono de un cliente particular
puede aparecer en un archivo que contenga
registros de cuentas de ahorros y en un archivo que
contenga registros de una cuenta corriente. Esta
redundancia conduce a un almacenamiento y coste
de acceso más altos. Además, puede conducir a
inconsistencia de datos; es decir, las diversas
copias de los mismos datos pueden no coincidir.
Por ejemplo, un cambio en la dirección del cliente
puede estar reflejado en los registros de las cuentas
de ahorro pero no estarlo en el resto del sistema.
VISIÓN DE LOS DATOS
Un sistema de bases de datos es una colección de archivos
interrelacionados y un conjunto de programas que
permitan a los usuarios acceder y modificar estos archivos.
Uno de los propósitos principales de un sistema de bases de datos es proporcionar a los usuarios una
visión abstracta de los datos. Es decir, el sistema esconde
ciertos detalles de cómo se almacenan y mantienen
los datos.
• Nivel físico: El nivel más bajo de abstracción describe
cómo se almacenan realmente los datos. En
el nivel físico se describen en detalle las estructuras
de datos complejas de bajo nivel.
• Nivel lógico: El siguiente nivel más alto de abstracción
describe qué datos se almacenan en la
base de datos y qué relaciones existen entre esos
datos. La base de datos completa se describe así
en términos de un número pequeño de estructuras
relativamente simples. Aunque la implementación
de estructuras simples en el nivel lógico
puede involucrar estructuras complejas del nivel
físico, los usuarios del nivel lógico no necesitan
preocuparse de esta complejidad. Los administradores
de bases de datos, que deben decidir la
información que se mantiene en la base de datos,
usan el nivel lógico de abstracción.
• Nivel de vistas: El nivel más alto de abstracción
describe sólo parte de la base de datos completa.
A pesar del uso de estructuras más simples en el
nivel lógico, queda algo de complejidad, debido a
la variedad de información almacenada en una gran
base de datos. Muchos usuarios del sistema de base
de datos no necesitan toda esta información. En su
lugar, tales usuarios necesitan acceder sólo a una
parte de la base de datos. Para que su interacción
con el sistema se simplifique, se define la abstracción
del nivel de vistas. El sistema puede proporcionar
muchas vistas para la misma base de datos.
Bajo la estructura de la base de datos se encuentra el
modelo de datos: una colección de herramientas conceptuales
para describir los datos, las relaciones, la
semántica y las restricciones de consistencia. Para ilustrar
el concepto de un modelo de datos, describimos dos
modelos de datos en este apartado: el modelo entidadrelación
y el modelo relacional. Los diferentes modelos
de datos que se han propuesto se clasifican en tres
grupos diferentes: modelos lógicos basados en objetos,
modelos lógicos basados en registros y modelos físicos.
Modelo entidad-relación
El modelo de datos entidad-relación (E-R) está basado
en una percepción del mundo real que consta de una
colección de objetos básicos, llamados entidades, y de
relaciones entre estos objetos. Una entidad es una «cosa»
u «objeto» en el mundo real que es distinguible de otros
objetos. Por ejemplo, cada persona es una entidad, y las
cuentas bancarias pueden ser consideradas entidades.
Las entidades se describen en una base de datos
mediante un conjunto de atributos. Por ejemplo, los
atributos número-cuenta y saldo describen una cuenta
particular de un banco y pueden ser atributos del conjunto
de entidades cuenta. Análogamente, los atributos
nombre-cliente, calle-cliente y ciudad-cliente pueden
describir una entidad cliente.
Un sistema de bases de datos proporciona un lenguaje de
definición de datos para especificar el esquema de la base
de datos y un lenguaje de manipulación de datos para
expresar las consultas a la base de datos y las modificaciones.
En la práctica, los lenguajes de definición y manipulación
de datos no son dos lenguajes separados; en su
lugar simplemente forman partes de un único lenguaje de
bases de datos, tal como SQL, ampliamente usado.
1.5.1. Lenguaje de definición de datos
Un esquema de base de datos se especifica mediante un
conjunto de definiciones expresadas mediante un lenguaje
especial llamado lenguaje de definición de datos
(LDD).
Por ejemplo, la siguiente instrucción en el lenguaje
SQL define la tabla cuenta:
create table cuenta
(número-cuenta char(10),
saldo integer)
La ejecución de la instrucción LDD anterior crea la
tabla cuenta. Además, actualiza un conjunto especial de
tablas denominado diccionario de datos o directorio
de datos.
Un diccionario de datos contiene metadatos, es decir,
datos acerca de los datos. El esquema de una tabla es
un ejemplo de metadatos. Un sistema de base de datos
consulta el diccionario de datos antes de leer o modificar
los datos reales.
Especificamos el almacenamiento y los métodos de
acceso usados por el sistema de bases de datos por un
conjunto de instrucciones en un tipo especial de LDD
denominado lenguaje de almacenamiento y definición
de datos. Estas instrucciones definen los detalles de
implementación de los esquemas de base de datos, que
se ocultan usualmente a los usuarios.
Los valores de datos almacenados en la base de datos
deben satisfacer ciertas restricciones de consistencia.
Por ejemplo, supóngase que el saldo de una cuenta no
debe caer por debajo de 100 €. El LDD proporciona
facilidades para especificar tales restricciones. Los sistemas
de bases de datos comprueban estas restricciones
cada vez que se actualiza la base de datos.
1.5.2. Lenguaje de manipulación de datos
La manipulación de datos es:
• La recuperación de información almacenada en la
base de datos.
• La inserción de información nueva en la base de
datos.
• El borrado de información de la base de datos.
• La modificación de información almacenada en la
base de datos.
Un lenguaje de manipulación de datos (LMD) es
un lenguaje que permite a los usuarios acceder o manipular
los datos organizados mediante el modelo de datos
apropiado. Hay dos tipos básicamente:
• LMDs procedimentales. Requieren que el usuario
especifique qué datos se necesitan y cómo obtener
esos datos.
• LMDs declarativos (también conocidos como
LMDs no procedimentales). Requieren que el
usuario especifique qué datos se necesitan sin especificar
cómo obtener esos datos.
Los LMDs declarativos son más fáciles de aprender
y usar que los LMDs procedimentales. Sin embargo,
como el usuario no especifica cómo conseguir los datos,
el sistema de bases de datos tiene que determinar un
medio eficiente de acceder a los datos. El componente
LMD del lenguaje SQL es no procedimental.
Un objetivo principal de un sistema de bases de datos es
recuperar información y almacenar nueva información
en la base de datos. Las personas que trabajan con una
base de datos se pueden catalogar como usuarios de bases
de datos o como administradores de bases de datos.
Usuarios de bases de datos e interfaces
de usuario
Hay cuatro tipos diferentes de usuarios de un sistema
de base de datos, diferenciados por la forma en que ellos
esperan interactuar con el sistema. Se han diseñado diferentes
tipo de interfaces de usuario para diferentes tipos
de usuarios.
• Usuarios normales. Son usuarios no sofisticados
que interactúan con el sistema mediante la invocación
de alguno de los programas de aplicación
permanentes que se ha escrito previamente. Por
ejemplo, un cajero bancario que necesita transferir
50 € de la cuenta A a la cuenta B invoca un programa
llamado transferir. Este programa pide al de la que el dinero va a ser transferido y la cuenta
a la que el dinero va a ser transferido.
Como otro ejemplo, considérese un usuario que
desee encontrar su saldo de cuenta en World Wide
Web. Tal usuario podría acceder a un formulario
en el que introduce su número de cuenta. Un programa
de aplicación en el servidor Web recupera
entonces el saldo de la cuenta, usando el número
de cuenta proporcionado, y pasa la información al
usuario.
La interfaz de usuario normal para los usuarios
normales es una interfaz de formularios, donde el
usuario puede rellenar los campos apropiados del
formulario. Los usuarios normales pueden también
simplemente leer informes generados de la
base de datos.
Varias operaciones sobre la base de datos forman a
menudo una única unidad lógica de trabajo. Un ejemplo
que se vio en el Apartado es la transferencia de
fondos, en el que una cuenta (A) se carga y otra cuenta
(B) se abona. Claramente es esencial que, o bien tanto
el cargo como el abono tengan lugar, o bien no ocurra
ninguno. Es decir, la transferencia de fondos debe ocurrir
por completo o no ocurrir en absoluto. Este requisito
de todo o nada se denomina atomicidad. Además, es
esencial que la ejecución de la transferencia de fondos
preserve la consistencia de la base de datos. Es decir, el
valor de la suma A + B se debe preservar. Este requisito
de corrección se llama consistencia. Finalmente, tras
la ejecución correcta de la transferencia de fondos, los
nuevos valores de las cuentas A y B deben persistir, a
pesar de la posibilidad de fallo del sistema. Este requisito
de persistencia se llama durabilidad.
Una transacción es una colección de operaciones
que se lleva a cabo como una única función lógica en
una aplicación de bases de datos. Cada transacción es
una unidad de atomicidad y consistencia. Así, se requiere
que las transacciones no violen ninguna restricción
de consistencia de la base de datos. Es decir, si la base
de datos era consistente cuando la transacción comenzó,
la base de datos debe ser consistente cuando la transacción
termine con éxito. Sin embargo, durante la ejecución
de una transacción, puede ser necesario permitir
inconsistencias temporalmente, ya que o el cargo de A
o el abono de B se debe realizar uno antes que otro. Esta
inconsistencia temporal, aunque necesaria, puede conducir
a dificultades si ocurre un fallo.
Un sistema de bases de datos se divide en módulos que
se encargan de cada una de las responsabilidades del sistema
completo. Los componentes funcionales de un
sistema de bases de datos se pueden dividir a grandes
rasgos en los componentes gestor de almacenamiento
y procesador de consultas.
El gestor de consultas es importante porque las bases
de datos requieren normalmente una gran cantidad de espacio de almacenamiento. Las bases de datos corporativas
tienen un tamaño de entre cientos de gigabytes
y, para las mayores bases de datos, terabytes de datos.
Un gigabyte son 1.000 megabytes (1.000 millones de
bytes), y un terabyte es 1 millón de megabytes (1 billón
de bytes). Debido a que la memoria principal de los
computadores no puede almacenar esta gran cantidad
de información, esta se almacena en discos. Los datos
se trasladan entre el disco de almacenamiento y la
memoria principal cuando es necesario. Como la transferencia
de datos a y desde el disco es lenta comparada
con la velocidad de la unidad central de procesamiento,
es fundamental que el sistema de base de datos
estructure los datos para minimizar la necesidad de
movimiento de datos entre el disco y la memoria principal.
El procesador de consultas es importante porque ayuda
al sistema de bases de datos a simplificar y facilitar
el acceso a los datos. Las vistas de alto nivel ayudan a
conseguir este objetivo. Con ellas, los usuarios del sistema
no deberían ser molestados innecesariamente con
los detalles físicos de implementación del sistema. Sin
embargo, el rápido procesamiento de las actualizaciones
y de las consultas es importante. Es trabajo del sistema
de bases de datos traducir las actualizaciones y las
consultas escritas en un lenguaje no procedimental, en
el nivel lógico, en una secuencia de operaciones en el
nivel físico.
La mayoría de usuarios de un sistema de bases de datos
no están situados actualmente junto al sistema de bases
de datos, sino que se conectan a él a través de una red.
Se puede diferenciar entonces entre las máquinas cliente,
en donde trabajan los usuarios remotos de la base de
datos, y las máquinas servidor, en las que se ejecuta el
sistema de bases de datos.
Las aplicaciones de bases de datos se dividen usualmente
en dos o tres partes, como se ilustra en la Figura
1.5. En una arquitectura de dos capas, la aplicación
se divide en un componente que reside en la
máquina cliente, que llama a la funcionalidad del sistema
de bases de datos en la máquina servidor mediante
instrucciones del lenguaje de consultas. Los estándares
de interfaces de programas de aplicación como
ODBC y JDBC se usan para la interacción entre el
cliente y el servidor.
En cambio, en una arquitectura de tres capas, la
máquina cliente actúa simplemente como frontal y no
contiene ninguna llamada directa a la base de datos. En
su lugar, el cliente se comunica con un servidor de aplicaciones,
usualmente mediante una interfaz de formularios.
El servidor de aplicaciones, a su vez, se comunica
con el sistema de bases de datos para acceder a los datos.
La lógica de negocio de la aplicación, que establece las
acciones a realizar bajo determinadas condiciones, se
incorpora en el servidor de aplicaciones, en lugar de ser
distribuida a múltiples clientes. Las aplicaciones de tres
capas son más apropiadas para grandes aplicaciones, y
para las aplicaciones que se ejecutan en World Wide Web.
El procesamiento de datos impulsa el crecimiento de
los computadores, como ocurriera en los primeros días
de los computadores comerciales. De hecho, la automatización
de las tareas de procesamiento de datos precede
a los computadores. Las tarjetas perforadas, inventadas
por Hollerith, se usaron en los principios del
siglo xx para registrar los datos del censo de los EE.UU.,
y se usaron sistemas mecánicos para procesar las tarjetas
y para tabular los resultados. Las tarjetas perforadas
posteriormente se usaron ampliamente como medio para
introducir datos en los computadores.
Las técnicas del almacenamiento de datos han evolucionado
a lo largo de los años:
• Década de 1950 y principios de la década de 1960.
Se desarrollaron las cintas magnéticas para el almacenamiento
de datos. Las tareas de procesamiento
de datos tales como las nóminas fueron automatizadas,
con los datos almacenados en cintas. El procesamiento
de datos consistía en leer datos de una
o más cintas y escribir datos en una nueva cinta. Los
datos también se podían introducir desde paquetes
de tarjetas perforadas e impresos en impresoras. Por
ejemplo, los aumentos de sueldo se procesaban
introduciendo los aumentos en las tarjetas perforadas
y leyendo el paquete de cintas perforadas en sincronización
con una cinta que contenía los detalles
maestros de los salarios. Los registros debían estar
igualmente ordenados. Los aumentos de sueldo tenían
que añadirse a los sueldos leídos de la cinta maestra,
y escribirse en una nueva cinta; esta nueva cinta
se convertía en la nueva cinta maestra.
Las cintas (y los paquetes de tarjetas perforadas)
sólo se podían leer secuencialmente, y los
tamaños de datos eran mucho mayores que la
memoria principal; así, los programas de procesamiento
de datos tenían que procesar los datos según
un determinado orden, leyendo y mezclando datos
de cintas y paquetes de tarjetas perforadas.
MODELO ENTIDAD-RELACIÓN

Conjuntos de entidades
Una entidad es una «cosa» u «objeto» en el mundo real
que es distinguible de todos los demás objetos. Por ejemplo,
cada persona en un desarrollo es una entidad. Una
entidad tiene un conjunto de propiedades, y los valores
para algún conjunto de propiedades pueden identificar
una entidad de forma unívoca. Por ejemplo, el D.N.I.
67.789.901 identifica unívocamente una persona particular
en la empresa. Análogamente, se puede pensar
en los préstamos bancarios como entidades, y un número
de préstamo P-15 en la sucursal de Castellana identifica
unívocamente una entidad de préstamo. Una entidad
puede ser concreta, como una persona o un libro, o
puede ser abstracta, como un préstamo, unas vacaciones
o un concepto.
Un conjunto de entidades es un conjunto de entidades
del mismo tipo que comparten las mismas propiedades,
o atributos. El conjunto de todas las personas
que son clientes en un banco dado, por ejemplo, se pueden
definir como el conjunto de entidades cliente. Análogamente,
el conjunto de entidades préstamo podría
representar el conjunto de todos los préstamos concedidos
por un banco particular. Las entidades individuales
que constituyen un conjunto se llaman la extensión del
conjunto de entidades. Así, todos los clientes de un banco
son la extensión del conjunto de entidades cliente.
Los conjuntos de entidades no son necesariamente disjuntos.
Por ejemplo, es posible definir el conjunto de entidades
de todos los empleados de un banco (empleado) y
el conjunto de entidades de todos los clientes del banco
(cliente). Una entidad persona puede ser una entidad
empleado, una entidad cliente, ambas cosas, o ninguna.
Una entidad se representa mediante un conjunto de
atributos. Los atributos describen propiedades que
posee cada miembro de un conjunto de entidades. La
designación de un atributo para un conjunto de entidades
expresa que la base de datos almacena información
similar concerniente a cada entidad del conjunto de entidades;
sin embargo, cada entidad puede tener su propio
valor para cada atributo. Posibles atributos del conjunto
de entidades cliente son id-cliente, nombre-cliente,
calle-cliente y ciudad-cliente. En la vida real, habría
más atributos, tales como el número de la calle, el número
del portal, la provincia, el código postal, y la comunidad
autónoma, pero no se incluyen en el ejemplo simple.
Posibles atributos del conjunto de entidades
préstamo son número-préstamo e importe.
Cada entidad tiene un valor para cada uno de sus
atributos. Por ejemplo, una entidad cliente en concreto
puede tener el valor 32.112.312 para id-cliente, el valor
Santos para nombre-cliente, el valor Mayor para callecliente
y el valor Peguerinos para ciudad-cliente.
El atributo id-cliente se usa para identificar unívocamente
a los clientes, dado que no hay más de un cliente
con el mismo nombre, calle y ciudad. En los Estados
Unidos, muchas empresas encuentran conveniente usar
el número seguridad-social de una persona1 como un
2.1. CONCEPTOS BÁSICOS
1 En España se asigna a cada persona del país un número único, denominado
número del documento nacional de identidad (D.N.I.) para
identificarla unívocamente. Se supone que cada persona tiene un
único D.N.I., y no hay dos personas con el mismo D.N.I.
atributo cuyo valor identifica unívocamente a la persona.
En general la empresa tendría que crear y asignar
un identificador a cada cliente.

a las que los contenidos de la base de datos
se deben adaptar. En este apartado se examina la correspondencia
de cardinalidades y las restricciones de participación,
que son dos de los tipos más importantes de
restricciones.
número de entidades en B (ninguna o varias).
Una entidad en B, sin embargo, se puede asociar con
a lo sumo una entidad en A (véase la Figura 2.4b).
• Varios a uno. Una entidad en A se asocia con a lo
sumo una entidad en B. Una entidad en B, sin embargo,
se puede asociar con cualquier número de entidades
(ninguna o varias) en A (véase la Figura 2.5a).
• Varios a varios. Una entidad en A se asocia con
cualquier número de entidades (ninguna o varias)
en B, y una entidad en B se asocia con cualquier
número de entidades (ninguna o varias) en A

entidades dentro de un conjunto de entidades dado y las
relaciones dentro de un conjunto de relaciones dado son
distinguibles. Conceptualmente las entidades y relaciones
individuales son distintas; desde una perspectiva
de bases de datos, sin embargo, la diferencia entre
ellas se debe expresar en término de sus atributos.
Por lo tanto, los valores de los atributos de una entidad
deben ser tales que permitan identificar unívocamente
a la entidad. En otras palabras, no se permite que
ningún par de entidades tengan exactamente los mismos
valores de sus atributos.
Una clave permite identificar un conjunto de atributos
suficiente para distinguir las entidades entre sí. Las
claves también ayudan a identificar unívocamente a las
relaciones y así a distinguir las relaciones entre sí.
Una superclave es un conjunto de uno o más atributos
que, tomados colectivamente, permiten identificar de
forma única una entidad en el conjunto de entidades.
Por ejemplo, el atributo id-cliente del conjunto de entidades
cliente es suficiente para distinguir una entidad
cliente de las otras. Así, id-cliente es una superclave.
Análogamente, la combinación de nombre-cliente e idcliente
es una superclave del conjunto de entidades cliente.
El atributo nombre-cliente de cliente no es una superclave,
porque varias personas podrían tener el mismo
nombre.
Considérese el conjunto de entidades empleado con los
atributos nombre-empleado y número-teléfono. Se puede
argumentar fácilmente que un teléfono es una entidad
por sí misma con atributos número-teléfono y ubicación
(la oficina donde está ubicado el teléfono). Si se
toma este punto de vista, el conjunto de entidades empleado
debe ser redefinido como sigue:
• El conjunto de entidades empleado con el atributo
nombre-empleado
• El conjunto de entidades teléfono con atributos
número-teléfono y ubicación
• La relación empleado-teléfono, que denota la asociación
entre empleados y los teléfonos que tienen.
¿Cuál es, entonces, la diferencia principal entre esas
dos definiciones de un empleado? Al tratar un teléfono
como un atributo número-teléfono implica que cada
empleado tiene precisamente un número de teléfono. Al
tratar un teléfono como una entidad teléfono permite
que los empleados puedan tener varios números de teléfono
(incluido ninguno) asociados a ellos. Sin embargo,
se podría definir fácilmente número-teléfono como
un atributo multivalorado para permitir varios teléfonos
por empleado.


El modelo de datos E-R da una flexibilidad sustancial
en el diseño de un esquema de bases de datos para modelar
una empresa dada. En este apartado se considera
cómo un diseñador de bases de datos puede seleccionar
entre el amplio rango de alternativas. Entre las decisiones
que se toman están las siguientes:
• Si se usa un atributo o un conjunto de entidades
para representa un objeto (discutido anteriormente
en el Apartado 2.2.1)
• Si un concepto del mundo real se expresa más exactamente
mediante un conjunto de entidades o mediante
un conjunto de relaciones (Apartado 2.2.2)
• Si se usa una relación ternaria o un par de relaciones
binaras (Apartado 2.2.3)
• Si se usa un conjunto de entidades fuertes o débiles
(Apartado 2.6); un conjunto de entidades fuertes
y sus conjuntos de entidades débiles dependientes
se pueden considerar como un «objeto» en
la base de datos, debido a que la existencia de las
entidades débiles depende de la entidad fuerte
• Si el uso de la generalización (Apartado 2.7.2) es
apropiado; la generalización, o una jerarquía de
relaciones ES, contribuye a la modularidad por
permitir que los atributos comunes de conjuntos
de entidades similares se representen en un único
lugar en un diagrama E-R
• Si el uso de la agregación (Apartado 2.7.5) es apropiado;
la agregación agrupa una parte de un diagrama E-R en un único conjunto de entidades, permitiendo
tratar el conjunto de entidades de la agregación
como una unidad única sin importar los
detalles de su estructura interna.

Los diagramas entidad-relación ayudan a modelar el
componente de representación de datos de un sistema
software. La representación de datos, sin embargo,
sólo forma parte de un diseño completo de un sistema.
Otros componentes son modelos de interacción
del usuario con el sistema, especificación de módulos
funcionales del sistema y su interacción, etc. El
lenguaje de modelado unificado (UML, Unified
Modeling Language) es un estándar propuesto para la
creación de especificaciones de varios componentes
de un sistema software. Algunas de las partes de UML
son:
• Diagrama de clase. Un diagrama de clase es similar
a un diagrama E-R. Más adelante en este apartado
se mostrarán algunas características de los diagramas
de clase y cómo se corresponden con los
diagramas E-R.
• Diagrama de caso de uso. Los diagramas de caso
de uso muestran la interacción entre los usuarios
y el sistema, en particular los pasos de las tareas
que realiza el usuario (tales como prestar dinero o
matricularse de una asignatura).
• Diagrama de actividad. Los diagramas de actividad
describen el flujo de tareas entre varios componentes
de un sistema.
• Diagrama de implementación. Los diagramas de
implementación muestran los componentes del sistema
y sus interconexiones tanto en el nivel del
componente software como el hardware.
Aquí no se intentará proporcionar un tratamiento
detallado de las diferentes partes de UML. Véanse las
notas bibliográficas para encontrar referencias de UML.


Las operaciones básicas del álgebra relacional se han
ampliado de varias maneras. Una ampliación sencilla
es permitir operaciones aritméticas como parte de la
proyección. Una ampliación importante es permitir operaciones
de agregación, como el cálculo de la suma de
los elementos de un conjunto, o su media. Otra ampliación
importante es la operación reunión externa, que
permite a las expresiones del álgebra relacional trabajar
con los valores nulos que modelan la información
que falta.
3.3.1. Proyección generalizada
La operación proyección generalizada amplía la operación
proyección permitiendo que se utilicen funciones
aritméticas en la lista de proyección. La operación
proyección generalizada tiene la forma
ΠF1, F2, …, Fn (E)
donde E es cualquier expresión del álgebra relacional y
F1, F2, …, Fn son expresiones aritméticas que incluyen
constantes y atributos en el esquema de E. Como caso
especial la expresión aritmética puede ser simplemente
un atributo o una constante.
Por ejemplo, supóngase que se dispone de una relación
información-crédito, como se muestra en la Figura
3.25, que da el límite de crédito y el importe dispuesto
hasta el momento presente (el saldo-crédito de la
cuenta). Si se desea averiguar el importe disponible por
cada persona, se puede escribir la expresión siguiente:
Πnombre-cliente, límite - saldo-crédito (información-crédito)
El atributo resultante de la expresión límite – saldo-crédito
no tiene un nombre. Se puede aplicar la operación
renombramiento al resultado de la proyección generalizada
para darle un nombre. Como conveniencia notacional,
el renombramiento de atributos se puede
combinar con la proyección generalizada como se ilustra
a continuación:
Πnombre-cliente, (límite – saldo-crédito) as crédito-disponible
(información-crédito)
de información de la base de datos. En este apartado
se abordará la manera de insertar, borrar o modificar
información de la base de datos.
Las modificaciones de la base de datos se expresan
utilizando la operación asignación. Las asignaciones a
las relaciones reales de la base de datos se realizan utilizando
la misma notación que se describió para la asignación
en el Apartado 3.2.3.
Las solicitudes de borrado se expresan básicamente igual
que las consultas. Sin embargo, en lugar de mostrar las tuplas al usuario, se eliminan de la base de datos las tuplas
seleccionadas. Sólo se pueden borrar tuplas enteras; no
se pueden borrar valores de atributos concretos. En el
álgebra relacional los borrados se expresan mediante
r ← r – E
donde r es una relación y E es una consulta del álgebra
relacional.
He aquí varios ejemplos de solicitudes de borrado
del álgebra relacional:
• Borrar todas las cuentas de Gómez.
impositor ← impositor – σnombre-cliente
= «Gómez» (impositor)
• Borrar todos los préstamos con importes entre 0 y
50.
préstamo ← préstamo – σimporte ≥ 0 and importe
≤ 50 (préstamo)
• Borrar todas las cuentas de las sucursales sitas en
Getafe.
r1 ←σciudad-sucursal = «Getafe» (cuenta sucursal)
r2← Πnombre-sucursal, número-cuenta, saldo (r1)
cuenta ← cuenta – r2
Obsérvese que en el último ejemplo se simplificó
la expresión utilizando la asignación a las relaciones
temporales (r1 y r2).

en el nivel del modelo lógico. Es decir, se ha asumido
que el conjunto de relaciones que se da son las relaciones
reales guardadas en la base de datos.
No es deseable que todos los usuarios puedan ver la
totalidad del modelo lógico. Las consideraciones sobre
la seguridad pueden exigir que algunos datos queden
ocultos para los usuarios. Considérese una persona que
necesita saber el número de préstamo de un cliente pero
que no necesita ver el importe del préstamo. Esta persona
debería ver una relación descrita en el álgebra relacional
mediante
Πnombre-cliente, número-préstamo, nombre-sucursal
(prestatario préstamo)
Aparte de las consideraciones sobre la seguridad puede
que se desee crear un conjunto personalizado de relaciones
que se adapte mejor que el modelo lógico a la
intuición de un usuario concreto. Por ejemplo, puede
que un empleado del departamento de publicidad quiera
ver una relación que conste de los clientes que tengan
abierta una cuenta o concedido un préstamo en el banco
y de las sucursales con las que trabajan. La relación que
se crearía para ese empleado es
Πnombre-sucursal, nombre-cliente (impositor cuenta)
∪Πnombre-sucursal, nombre-cliente (prestatario préstamo)

Cuando escribimos una expresión del álgebra relacional
proporcionamos una serie de procedimientos que
generan la respuesta a la consulta. El cálculo relacional
de tuplas, en cambio, es un lenguaje de consulta no procedimental.
Describe la información deseada sin dar
un procedimiento específico para obtenerla.
Las consultas se expresan en el cálculo relacional de
tuplas como
{t | P(t)}
es decir, son el conjunto de todas las tuplas tales que el
predicado P es cierto para t. Siguiendo la notación utilizada
previamente, se utiliza t[A] para denotar el valor
de la tupla t en el atributo A y t ∈ r para denotar que la
tupla t está en la relación r.
Antes de dar una definición formal del cálculo relacional
de tuplas se volverán a examinar algunas de las
consultas para las que se escribieron expresiones de
álgebra relacional en el Apartado 3.2.
MODELO ENTIDAD-RELACIÓN
CONCEPTOS BÁSICOS
Una entidad es una «cosa» u «objeto» en el mundo real
que es distinguible de todos los demás objetos. Por ejemplo,
cada persona en un desarrollo es una entidad. Una
entidad tiene un conjunto de propiedades, y los valores
para algún conjunto de propiedades pueden identificar
una entidad de forma unívoca. Por ejemplo, el D.N.I.
67.789.901 identifica unívocamente una persona particular
en la empresa. Análogamente, se puede pensar
en los préstamos bancarios como entidades, y un número
de préstamo P-15 en la sucursal de Castellana identifica
unívocamente una entidad de préstamo. Una entidad
puede ser concreta, como una persona o un libro, o
puede ser abstracta, como un préstamo, unas vacaciones
o un concepto.
Un conjunto de entidades es un conjunto de entidades
del mismo tipo que comparten las mismas propiedades,
o atributos. El conjunto de todas las personas
que son clientes en un banco dado, por ejemplo, se pueden
definir como el conjunto de entidades cliente. Análogamente,
el conjunto de entidades préstamo podría
representar el conjunto de todos los préstamos concedidos
por un banco particular. Las entidades individuales
que constituyen un conjunto se llaman la extensión del
conjunto de entidades. Así, todos los clientes de un banco
son la extensión del conjunto de entidades cliente.
Los conjuntos de entidades no son necesariamente disjuntos.
Por ejemplo, es posible definir el conjunto de entidades
de todos los empleados de un banco (empleado) y
el conjunto de entidades de todos los clientes del banco
(cliente). Una entidad persona puede ser una entidad
empleado, una entidad cliente, ambas cosas, o ninguna.
Una entidad se representa mediante un conjunto de
atributos. Los atributos describen propiedades que
posee cada miembro de un conjunto de entidades. La
designación de un atributo para un conjunto de entidades
expresa que la base de datos almacena información
similar concerniente a cada entidad del conjunto de entidades;
sin embargo, cada entidad puede tener su propio
valor para cada atributo. Posibles atributos del conjunto
de entidades cliente son id-cliente, nombre-cliente,
calle-cliente y ciudad-cliente. En la vida real, habría
más atributos, tales como el número de la calle, el número
del portal, la provincia, el código postal, y la comunidad
autónoma, pero no se incluyen en el ejemplo simple.
Posibles atributos del conjunto de entidades
préstamo son número-préstamo e importe.
Cada entidad tiene un valor para cada uno de sus
atributos. Por ejemplo, una entidad cliente en concreto
puede tener el valor 32.112.312 para id-cliente, el valor
Santos para nombre-cliente, el valor Mayor para callecliente
y el valor Peguerinos para ciudad-cliente.
El atributo id-cliente se usa para identificar unívocamente
a los clientes, dado que no hay más de un cliente
con el mismo nombre, calle y ciudad. En los Estados
Unidos, muchas empresas encuentran conveniente usar
el número seguridad-social de una persona1 como un
2.1. CONCEPTOS BÁSICOS
1 En España se asigna a cada persona del país un número único, denominado
número del documento nacional de identidad (D.N.I.) para
identificarla unívocamente. Se supone que cada persona tiene un
único D.N.I., y no hay dos personas con el mismo D.N.I.
atributo cuyo valor identifica unívocamente a la persona.
En general la empresa tendría que crear y asignar
un identificador a cada cliente.
RESTRICCIONES
Un esquema de desarrollo E-R puede definir ciertas restriccionesa las que los contenidos de la base de datos
se deben adaptar. En este apartado se examina la correspondencia
de cardinalidades y las restricciones de participación,
que son dos de los tipos más importantes de
restricciones.
La correspondencia de cardinalidades, o razón de cardinalidad,
expresa el número de entidades a las que otra
entidad puede estar asociada vía un conjunto de relaciones.
La correspondencia de cardinalidades es la más útil
describiendo conjuntos de relaciones binarias, aunque
ocasionalmente contribuye a la descripción de conjuntos
de relaciones que implican más de dos conjuntos de
entidades. Este apartado se centrará en conjuntos de
relaciones binarias únicamente.
Para un conjunto de relaciones binarias R entre los
conjuntos de entidades A y B, la correspondencia de cardinalidades
debe ser una de las siguientes:
• Uno a uno. Una entidad en A se asocia con a lo
sumo una entidad en B, y una entidad en B se asocia
con a lo sumo una entidad en A
• Uno a varios. Una entidad en A se asocia con cualquiernúmero de entidades en B (ninguna o varias).
Una entidad en B, sin embargo, se puede asociar con
a lo sumo una entidad en A (véase la Figura 2.4b).
• Varios a uno. Una entidad en A se asocia con a lo
sumo una entidad en B. Una entidad en B, sin embargo,
se puede asociar con cualquier número de entidades
(ninguna o varias) en A (véase la Figura 2.5a).
• Varios a varios. Una entidad en A se asocia con
cualquier número de entidades (ninguna o varias)
en B, y una entidad en B se asocia con cualquier
número de entidades (ninguna o varias) en A
CLAVES
relaciones dentro de un conjunto de relaciones dado son
distinguibles. Conceptualmente las entidades y relaciones
individuales son distintas; desde una perspectiva
de bases de datos, sin embargo, la diferencia entre
ellas se debe expresar en término de sus atributos.
Por lo tanto, los valores de los atributos de una entidad
deben ser tales que permitan identificar unívocamente
a la entidad. En otras palabras, no se permite que
ningún par de entidades tengan exactamente los mismos
valores de sus atributos.
Una clave permite identificar un conjunto de atributos
suficiente para distinguir las entidades entre sí. Las
claves también ayudan a identificar unívocamente a las
relaciones y así a distinguir las relaciones entre sí.
Una superclave es un conjunto de uno o más atributos
que, tomados colectivamente, permiten identificar de
forma única una entidad en el conjunto de entidades.
Por ejemplo, el atributo id-cliente del conjunto de entidades
cliente es suficiente para distinguir una entidad
cliente de las otras. Así, id-cliente es una superclave.
Análogamente, la combinación de nombre-cliente e idcliente
es una superclave del conjunto de entidades cliente.
El atributo nombre-cliente de cliente no es una superclave,
porque varias personas podrían tener el mismo
nombre.
CUESTIONES DE DISEÑO
atributos nombre-empleado y número-teléfono. Se puede
argumentar fácilmente que un teléfono es una entidad
por sí misma con atributos número-teléfono y ubicación
(la oficina donde está ubicado el teléfono). Si se
toma este punto de vista, el conjunto de entidades empleado
debe ser redefinido como sigue:
• El conjunto de entidades empleado con el atributo
nombre-empleado
• El conjunto de entidades teléfono con atributos
número-teléfono y ubicación
• La relación empleado-teléfono, que denota la asociación
entre empleados y los teléfonos que tienen.
¿Cuál es, entonces, la diferencia principal entre esas
dos definiciones de un empleado? Al tratar un teléfono
como un atributo número-teléfono implica que cada
empleado tiene precisamente un número de teléfono. Al
tratar un teléfono como una entidad teléfono permite
que los empleados puedan tener varios números de teléfono
(incluido ninguno) asociados a ellos. Sin embargo,
se podría definir fácilmente número-teléfono como
un atributo multivalorado para permitir varios teléfonos
por empleado.
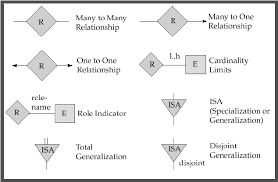
DIAGRAMA ENTIDAD-RELACIÓN
Como se vio brevemente en el Apartado 1.4, la estructura
lógica general de una base de datos se puede expresar
gráficamente mediante un diagrama E-R. Los diagramas
son simples y claros, cualidades que pueden ser
responsables del amplio uso del modelo E-R. Tal diagrama
consta de los siguientes componentes principales:
• Rectángulos, que representan conjuntos de entidades.
• Elipses, que representan atributos.
• Rombos, que representan relaciones.
• Líneas, que unen atributos a conjuntos de entidades
y conjuntos de entidades a conjuntos de relaciones.
• Elipses dobles, que representan atributos multivalorados.
• Elipses discontinuas, que denotan atributos derivados.
• Líneas dobles, que indican participación total de
una entidad en un conjunto de relaciones.
• Rectángulos dobles, que representan conjuntos
de entidades débiles (se describirán posteriormente
en el Apartado 2.6).
Considérese el diagrama entidad-relación de la Figura
2.8, que consta de dos conjuntos de entidades, cliente
y préstamo, relacionadas a través de un conjunto de
relaciones binarias prestatario. Los atributos asociados
con cliente son id-cliente, nombre-cliente, calle-cliente,
y ciudad-cliente. Los atributos asociados con préstamo
son número-préstamo e importe. Como se muestra
en la Figura 2.8, los atributos de un conjunto de
entidades que son miembros de la clave primaria están
subrayados.
El conjunto de relaciones prestatario puede ser varios
a varios, uno a varios, varios a uno o uno a uno. Para
distinguir entre estos tipos, se dibuja o una línea dirigida
(→) o una línea no dirigida (—) entre el conjunto de
relaciones y el conjunto de entidades en cuestión.
CONJUNTOS DE ENTIDADES DÉBILES
Un conjunto de entidades puede no tener suficientes atributos
para formar una clave primaria. Tal conjunto de
entidades se denomina conjunto de entidades débiles.
Un conjunto de entidades que tiene una clave primaria
se denomina conjunto de entidades fuertes.
Como ilustración, considérese el conjunto de entidades
pago, que tiene los tres atributos: número-pago,
fecha-pago e importe-pago. Los números de pago son
generalmente números secuenciales, empezando por 1,
generados por separado por cada préstamo. Así, aunque
cada entidad pago es distinta, los pagos para diferentes
préstamos pueden compartir el mismo número de pago.
Así, este conjunto de entidades no tiene una clave primaria;
es un conjunto de entidades débiles.
Para que un conjunto de entidades débiles tenga sentido,
debe estar asociada con otro conjunto de entidades,
denominado el conjunto de entidades identificadoras
o propietarias. Cada entidad débil debe estar
asociada con una entidad identificadora; es decir, se dice
que el conjunto de entidades débiles depende existencialmente
del conjunto de entidades identificadoras. Se
dice que el conjunto de entidades identificadoras es propietaria
del conjunto de entidades débiles que identifica.
La relación que asocia el conjunto de entidades débiles
con el conjunto de entidades identificadoras se
denomina relación identificadora. La relación identificadora
es varios a uno del conjunto de entidades débiles
al conjunto de entidades identificadoras y la participación
del conjunto de entidades débiles en la relación
es total.
CARACTERÍSTICAS DEL MODELO E-R EXTENDIDO
Aunque los conceptos básicos de E-R pueden modelar
la mayoría de las características de las bases de datos,
algunos aspectos de una base de datos pueden ser más
adecuadamente expresados mediante ciertas extensiones
del modelo E-R básico. En este apartado se discuten
las características E-R extendidas de especialización,
generalización, conjuntos de entidades de nivel
más alto y más bajo, herencia de atributos y agregación
DISEÑO DE UN ESQUEMA DE BASE DE DATOS E-R
en el diseño de un esquema de bases de datos para modelar
una empresa dada. En este apartado se considera
cómo un diseñador de bases de datos puede seleccionar
entre el amplio rango de alternativas. Entre las decisiones
que se toman están las siguientes:
• Si se usa un atributo o un conjunto de entidades
para representa un objeto (discutido anteriormente
en el Apartado 2.2.1)
• Si un concepto del mundo real se expresa más exactamente
mediante un conjunto de entidades o mediante
un conjunto de relaciones (Apartado 2.2.2)
• Si se usa una relación ternaria o un par de relaciones
binaras (Apartado 2.2.3)
• Si se usa un conjunto de entidades fuertes o débiles
(Apartado 2.6); un conjunto de entidades fuertes
y sus conjuntos de entidades débiles dependientes
se pueden considerar como un «objeto» en
la base de datos, debido a que la existencia de las
entidades débiles depende de la entidad fuerte
• Si el uso de la generalización (Apartado 2.7.2) es
apropiado; la generalización, o una jerarquía de
relaciones ES, contribuye a la modularidad por
permitir que los atributos comunes de conjuntos
de entidades similares se representen en un único
lugar en un diagrama E-R
• Si el uso de la agregación (Apartado 2.7.5) es apropiado;
la agregación agrupa una parte de un diagrama E-R en un único conjunto de entidades, permitiendo
tratar el conjunto de entidades de la agregación
como una unidad única sin importar los
detalles de su estructura interna.
REDUCCIÓN DE UN ESQUEMA E-R ATABLAS
Una base de datos que se ajusta a un esquema de bases
de datos E-R se puede representar por una colección
de tablas. Para cada conjunto de entidades de
la base de datos y para cada conjunto de relaciones de la
base de datos hay una única tabla a la que se asigna el
nombre del conjunto de entidades o del conjunto de relaciones
correspondiente. Cada tabla tiene varias columnas,
cada una de las cuales tiene un nombre único.
Los modelos E-R y el de bases de datos relacionales
son representaciones abstractas y lógicas de empresas
del mundo real. Debido a que los dos modelos
emplean principios de diseño similares, se puede convertir
un diseño E-R en un diseño relacional. Convertir
una representación de bases de datos de un diagrama
E-R a un formato de tablas es la base para la derivación
de un diseño de bases de datos relacional desde un diagrama
E-R. Aunque existen diferencias importantes
entre una relación y una tabla, una relación se puede
considerar informalmente como una tabla de valores.
En este apartado se describe cómo se puede representar
un esquema E-R mediante tablas; y en el Capítulo
3 se muestra cómo generar un esquema de bases de
datos relacional a partir de un esquema E-R.
Las restricciones especificadas en un diagrama E-R,
tales como las claves primarias y las restricciones de
cardinalidad, se corresponden con restricciones sobre
las tablas generadas a partir del diagrama E-R. Se proporcionan
más detalles sobre esta correspondencia en
el Capítulo 6 después de describir cómo especificar restricciones
sobre tablas.
EL LENGUAJE DE MODELADO UNIFICADO UML
componente de representación de datos de un sistema
software. La representación de datos, sin embargo,
sólo forma parte de un diseño completo de un sistema.
Otros componentes son modelos de interacción
del usuario con el sistema, especificación de módulos
funcionales del sistema y su interacción, etc. El
lenguaje de modelado unificado (UML, Unified
Modeling Language) es un estándar propuesto para la
creación de especificaciones de varios componentes
de un sistema software. Algunas de las partes de UML
son:
• Diagrama de clase. Un diagrama de clase es similar
a un diagrama E-R. Más adelante en este apartado
se mostrarán algunas características de los diagramas
de clase y cómo se corresponden con los
diagramas E-R.
• Diagrama de caso de uso. Los diagramas de caso
de uso muestran la interacción entre los usuarios
y el sistema, en particular los pasos de las tareas
que realiza el usuario (tales como prestar dinero o
matricularse de una asignatura).
• Diagrama de actividad. Los diagramas de actividad
describen el flujo de tareas entre varios componentes
de un sistema.
• Diagrama de implementación. Los diagramas de
implementación muestran los componentes del sistema
y sus interconexiones tanto en el nivel del
componente software como el hardware.
Aquí no se intentará proporcionar un tratamiento
detallado de las diferentes partes de UML. Véanse las
notas bibliográficas para encontrar referencias de UML.
EL modelo relacional
3.1. LA ESTRUCTURA DE LAS BASES DE DATOS RELACIONALES
Una base de datos relacional consiste en un conjunto de
tablas, a cada una de las cuales se le asigna un nombre
exclusivo. Cada tabla tiene una estructura parecida a la
presentada en el Capítulo 2, donde se representaron las
bases de datos E-R mediante tablas. Cada fila de la tabla
representa una relación entre un conjunto de valores.
Dado que cada tabla es un conjunto de dichas relaciones,
hay una fuerte correspondencia entre el concepto
de tabla y el concepto matemático de relación, del que
toma su nombre el modelo de datos relacional. A continuación
se introduce el concepto de relación.
En este capítulo se utilizarán varias relaciones diferentes
para ilustrar los conceptos subyacentes al modelo
de datos relacional. Estas relaciones representan parte
de una entidad bancaria. Se diferencian ligeramente de
las tablas que se utilizaron en el Capítulo 2, por lo que
se puede simplificar la representación. En el Capítulo 7
se estudiarán los criterios sobre la adecuación de las
estructuras relacionales.

3.1. LA ESTRUCTURA DE LAS BASES DE DATOS RELACIONALES
Una base de datos relacional consiste en un conjunto de
tablas, a cada una de las cuales se le asigna un nombre
exclusivo. Cada tabla tiene una estructura parecida a la
presentada en el Capítulo 2, donde se representaron las
bases de datos E-R mediante tablas. Cada fila de la tabla
representa una relación entre un conjunto de valores.
Dado que cada tabla es un conjunto de dichas relaciones,
hay una fuerte correspondencia entre el concepto
de tabla y el concepto matemático de relación, del que
toma su nombre el modelo de datos relacional. A continuación
se introduce el concepto de relación.
En este capítulo se utilizarán varias relaciones diferentes
para ilustrar los conceptos subyacentes al modelo
de datos relacional. Estas relaciones representan parte
de una entidad bancaria. Se diferencian ligeramente de
las tablas que se utilizaron en el Capítulo 2, por lo que
se puede simplificar la representación. En el Capítulo 7
se estudiarán los criterios sobre la adecuación de las
estructuras relacionales.
3.2. EL ÁLGEBRA RELACIONAL
El álgebra relacional es un lenguaje de consulta procedimental.
Consta de un conjunto de operaciones que
toman como entrada una o dos relaciones y producen
como resultado una nueva relación. Las operaciones
fundamentales del álgebra relacional son selección, proyección,
unión, diferencia de conjuntos, producto cartesiano
y renombramiento. Además de las operaciones
fundamentales hay otras operaciones, por ejemplo, intersección
de conjuntos, reunión natural, división y asignación.
Estas operaciones se definirán en términos de
las operaciones fundamentales.
El predicado de selección puede incluir comparaciones
entre dos atributos. Para ilustrarlo, considérese
la relación responsable-préstamo, que consta de tres
atributos: nombre-cliente, nombre-banquero y númeropréstamo,
que especifica que un empleado concreto es
el responsable del préstamo concedido a un cliente. Para
hallar todos los clientes que se llaman igual que su responsable
de préstamos se puede escribir
σnombre-cliente = nombre-banquero (responsable-préstamo)
3.3. OPERACIONES DEL ÁLGEBRA RELACIONAL EXTENDIDA
Las operaciones básicas del álgebra relacional se han
ampliado de varias maneras. Una ampliación sencilla
es permitir operaciones aritméticas como parte de la
proyección. Una ampliación importante es permitir operaciones
de agregación, como el cálculo de la suma de
los elementos de un conjunto, o su media. Otra ampliación
importante es la operación reunión externa, que
permite a las expresiones del álgebra relacional trabajar
con los valores nulos que modelan la información
que falta.
3.3.1. Proyección generalizada
La operación proyección generalizada amplía la operación
proyección permitiendo que se utilicen funciones
aritméticas en la lista de proyección. La operación
proyección generalizada tiene la forma
ΠF1, F2, …, Fn (E)
donde E es cualquier expresión del álgebra relacional y
F1, F2, …, Fn son expresiones aritméticas que incluyen
constantes y atributos en el esquema de E. Como caso
especial la expresión aritmética puede ser simplemente
un atributo o una constante.
Por ejemplo, supóngase que se dispone de una relación
información-crédito, como se muestra en la Figura
3.25, que da el límite de crédito y el importe dispuesto
hasta el momento presente (el saldo-crédito de la
cuenta). Si se desea averiguar el importe disponible por
cada persona, se puede escribir la expresión siguiente:
Πnombre-cliente, límite - saldo-crédito (información-crédito)
El atributo resultante de la expresión límite – saldo-crédito
no tiene un nombre. Se puede aplicar la operación
renombramiento al resultado de la proyección generalizada
para darle un nombre. Como conveniencia notacional,
el renombramiento de atributos se puede
combinar con la proyección generalizada como se ilustra
a continuación:
Πnombre-cliente, (límite – saldo-crédito) as crédito-disponible
(información-crédito)
3.4. MODIFICACIÓN DE LA BASE DE DATOS
Hasta ahora hemos centrado la atención en la extracciónde información de la base de datos. En este apartado
se abordará la manera de insertar, borrar o modificar
información de la base de datos.
Las modificaciones de la base de datos se expresan
utilizando la operación asignación. Las asignaciones a
las relaciones reales de la base de datos se realizan utilizando
la misma notación que se describió para la asignación
en el Apartado 3.2.3.
Las solicitudes de borrado se expresan básicamente igual
que las consultas. Sin embargo, en lugar de mostrar las tuplas al usuario, se eliminan de la base de datos las tuplas
seleccionadas. Sólo se pueden borrar tuplas enteras; no
se pueden borrar valores de atributos concretos. En el
álgebra relacional los borrados se expresan mediante
r ← r – E
donde r es una relación y E es una consulta del álgebra
relacional.
He aquí varios ejemplos de solicitudes de borrado
del álgebra relacional:
• Borrar todas las cuentas de Gómez.
impositor ← impositor – σnombre-cliente
= «Gómez» (impositor)
• Borrar todos los préstamos con importes entre 0 y
50.
préstamo ← préstamo – σimporte ≥ 0 and importe
≤ 50 (préstamo)
• Borrar todas las cuentas de las sucursales sitas en
Getafe.
r1 ←σciudad-sucursal = «Getafe» (cuenta sucursal)
r2← Πnombre-sucursal, número-cuenta, saldo (r1)
cuenta ← cuenta – r2
Obsérvese que en el último ejemplo se simplificó
la expresión utilizando la asignación a las relaciones
temporales (r1 y r2).
3.5. VISTAS
En los ejemplos propuestos hasta ahora se ha operadoen el nivel del modelo lógico. Es decir, se ha asumido
que el conjunto de relaciones que se da son las relaciones
reales guardadas en la base de datos.
No es deseable que todos los usuarios puedan ver la
totalidad del modelo lógico. Las consideraciones sobre
la seguridad pueden exigir que algunos datos queden
ocultos para los usuarios. Considérese una persona que
necesita saber el número de préstamo de un cliente pero
que no necesita ver el importe del préstamo. Esta persona
debería ver una relación descrita en el álgebra relacional
mediante
Πnombre-cliente, número-préstamo, nombre-sucursal
(prestatario préstamo)
Aparte de las consideraciones sobre la seguridad puede
que se desee crear un conjunto personalizado de relaciones
que se adapte mejor que el modelo lógico a la
intuición de un usuario concreto. Por ejemplo, puede
que un empleado del departamento de publicidad quiera
ver una relación que conste de los clientes que tengan
abierta una cuenta o concedido un préstamo en el banco
y de las sucursales con las que trabajan. La relación que
se crearía para ese empleado es
Πnombre-sucursal, nombre-cliente (impositor cuenta)
∪Πnombre-sucursal, nombre-cliente (prestatario préstamo)
3.6. EL CÁLCULO RELACIONAL DE TUPLAS
proporcionamos una serie de procedimientos que
generan la respuesta a la consulta. El cálculo relacional
de tuplas, en cambio, es un lenguaje de consulta no procedimental.
Describe la información deseada sin dar
un procedimiento específico para obtenerla.
Las consultas se expresan en el cálculo relacional de
tuplas como
{t | P(t)}
es decir, son el conjunto de todas las tuplas tales que el
predicado P es cierto para t. Siguiendo la notación utilizada
previamente, se utiliza t[A] para denotar el valor
de la tupla t en el atributo A y t ∈ r para denotar que la
tupla t está en la relación r.
Antes de dar una definición formal del cálculo relacional
de tuplas se volverán a examinar algunas de las
consultas para las que se escribieron expresiones de
álgebra relacional en el Apartado 3.2.

3.7. EL CÁLCULO RELACIONAL DE DOMINIOS
cálculo relacional de dominios. Esta forma utiliza
variables de dominio que toman sus valores del
dominio de un atributo, en vez de tomarlos de una tupla
completa. El cálculo relacional de dominios, sin embargo,
se halla estrechamente relacionado con el cálculo
relacional de tuplas.

SQL
Los lenguajes formales descritos en el Capítulo 3 proporcionan una notación concisa parala representación de consultas. Sin embargo, los sistemas de bases de datos comerciales
necesitan un lenguaje de consultas cómodo para el usuario. En este capítulo se estudia
el lenguaje comercial de mayor influencia, SQL. SQL usa una combinación de álgebra relacional
y construcciones del cálculo relacional.
Aunque el lenguaje SQL se considere un lenguaje de consultas, contiene muchas otras capacidades
además de la consulta en bases de datos. Incluye características para definir la estructura
de los datos, para la modificación de los datos en la base de datos y para la especificación
de restricciones de seguridad.
No se pretende proporcionar un manual de usuario completo para SQL. Por el contrario, se
presentan las construcciones y conceptos fundamentales de SQL. Las distintas implementaciones
de SQL pueden diferenciarse en detalles, o pueden admitir sólo un subconjunto del lenguaje
completo.

IBM desarrolló la versión original en su Laboratorio de
Investigación de San José (San José Research Center,
actualmente Centro de Investigación de Almadén, Almadén
Research Center). IBM implementó el lenguaje,
originalmente denominado Sequel, como parte del proyecto
System R, a principios de 1970. El lenguaje Sequel
ha evolucionado desde entonces y su nombre ha pasado
a ser SQL (Structured Query Language, Lenguaje
estructurado de consultas). Actualmente, numerosos
productos son compatibles con el lenguaje SQL. SQL
se ha establecido como el lenguaje estándar de bases de
datos relacionales.
• Lenguaje de definición de datos (LDD). El LDD
de SQL proporciona órdenes para la definición de
esquemas de relación, borrado de relaciones, creación
de índices y modificación de esquemas de
relación.
• Lenguaje interactivo de manipulación de datos
(LMD). El LMD de SQL incluye un lenguaje de
consultas, basado tanto en el álgebra relacional
como en el cálculo relacional de tuplas. Incluye
también órdenes para insertar, borrar y modificar
tuplas de la base de datos.
• Definición de vistas. El LDD de SQL incluye
órdenes para la definición de vistas.
• Control de transacciones. SQL incluye órdenes
para la especificación del comienzo y final de transacciones.
• SQL incorporado y SQL dinámico. SQL dinámico
e incorporado define cómo se pueden incorporar
las instrucciones SQL en lenguajes de programación de propósito general, tales como C,
C++, Java, PL/I, Cobol, Pascal y Fortran.

4.2. ESTRUCTURA BÁSICA
relaciones, a cada una de las cuales se le asigna un nombre
único. Cada relación tiene una estructura similar a
la presentada en el Capítulo 3. SQL permite el uso de
valores nulos para indicar que el valor o bien es desconocido,
o no existe. Se fijan criterios que permiten al
usuario especificar a qué atributos no se puede asignar
valor nulo, como estudiaremos en el Apartado 4.11.
La estructura básica de una expresión SQL consiste
en tres cláusulas: select, from y where.
• La cláusula select corresponde a la operación proyección
del álgebra relacional. Se usa para listar los
atributos deseados del resultado de una consulta.
• La cláusula from corresponde a la operación producto
cartesiano del álgebra relacional. Lista las
relaciones que deben ser analizadas en la evaluación
de la expresión.
• La cláusula where corresponde al predicado selección
del álgebra relacional. Es un predicado que
engloba a los atributos de las relaciones que aparecen
en la cláusula from.
Un hecho histórico desafortunado es que el término
select tiene un significado diferente en SQL que en el álgebra
relacional. A continuación se resaltan las diferentes
interpretaciones, a fin de minimizar la posible confusión.
Una consulta típica en SQL tiene la forma
select A1, A2,…, An
from r1, r2,…, rm
where P
Cada Ai representa un atributo, y cada ri una relación.
P es un predicado. La consulta es equivalente a la expresión
del álgebra relacional
Π A1, A2,…, An (σP (r1 × r2 × … × rm ))

4.3. OPERACIONES SOBRE CONJUNTOS
Las operaciones de SQL-92 union, intersect y except
operan sobre relaciones y corresponden a las operaciones
del álgebra relacional ∪, ∩ y –. Al igual que la
unión, intersección y diferencia de conjuntos en el álgebra
relacional, las relaciones que participan en las operaciones
han de ser compatibles; esto es, deben tener el
mismo conjunto de atributos.
A continuación se demuestra cómo se pueden formular
en SQL varias de las consultas de ejemplo consideradas
en el Capítulo 3 utilizando consultas que incluyen
las operaciones union, intersect y except de dos
conjuntos. Los dos conjuntos utilizados serán: el conjuntos
de todos los clientes que tienen una cuenta en el
banco, que puede obtenerse con:
select nombre-cliente
from impositor
y el conjunto de todos los clientes que tienen un préstamo
en el banco, que puede obtenerse con:
select nombre-cliente
from prestatario
Apartir de ahora, las letras i y p se utilizarán para hacer
referencia a las relaciones obtenidas como resultado de
las dos consultas anteriores.

4.4. FUNCIONES DE AGREGACIÓN
Las funciones de agregación son funciones que toman
una colección (un conjunto o multiconjunto) de valores
como entrada y producen un único valor como salida.
SQL proporciona cinco funciones de agregación primitivas:
• Media: avg
• Mínimo: min
• Máximo: max
• Total: sum
• Cuenta: count
La entrada a sum y avg debe ser una colección de
números, pero los otros operadores pueden operar sobre
colecciones de datos de tipo no numérico, tales como
las cadenas.
Como ejemplo, considérese la consulta «Obtener la
media de saldos de las cuentas de la sucursal Navacerrada
». Esta consulta se puede formular del modo siguiente:
select avg (saldo)
from cuenta
where nombre-sucursal = ‘Navacerrada’
El resultado de esta consulta será una relación con un único
atributo, que contendrá una única fila con un valor
numérico correspondiente al saldo medio de la sucursal
Navacerrada. Opcionalmente se puede dar un nombre al
atributo resultado de la relación, usando la cláusula as.
Existen situaciones en las cuales sería deseable aplicar
las funciones de agregación no sólo a un único conjunto
de tuplas sino también a un grupo de conjuntos de
tuplas; esto se especifica en SQL usando la cláusula
group by. El atributo o atributos especificados en la
cláusula group by se usan para formar grupos. Las tuplas
con el mismo valor en todos los atributos especificados
en la cláusula group by se colocan en un grupo

4.5. VALORES NULOS
SQL permite el uso de valores nulos para indicar la
ausencia de información sobre el valor de un atributo.
En un predicado se puede usar la palabra clave especial
null para comprobar si un valor es nulo. Así, para
encontrar todos los números de préstamo que aparecen
en la relación préstamo con valores nulos para importe
se escribe
select número-préstamo
from préstamo
where importe is null
El predicado is not null pregunta por la ausencia de un
valor nulo.
El uso de un valor nulo en las operaciones aritméticas
y de comparación causa varias complicaciones. En
el Apartado 3.3.4 se vio cómo se manejan los valores
nulos en el álgebra relacional. Ahora se describe cómo
maneja SQL los valores nulos.
El resultado de una expresión aritmética (incluyendo
por ejemplo +,–,* o /) es nulo si cualquiera de los
valores de entrada es nulo. SQL trata como desconocido
el resultado de cualquier comparación que implique
un valor nulo (aparte de is null e is not null).
Dado que el predicado en una cláusula where puede
incluir operaciones booleanas tales como and, or y
not sobre los resultados de las comparaciones, las definiciones
de estas operaciones se extienden para manejar
el valor desconocido, como se describe en el Apartado
3.3.4.
• and: el resultado de cierto and desconocido es desconocido,
falso and desconocido es falso, mientras
que desconocido and desconocido es desconocido.
• or: el resultado de cierto or desconocido es cierto,
falso or desconocido es desconocido, mientras
que desconocido or desconocido es desconocido.
SQL define el resultado de una instrucción SQL de la
forma
select … from R1, …., Rn where P

4.6. SUBCONSULTAS ANIDADAS
SQL proporciona un mecanismo para las subconsultas
anidadas. Una subconsulta es una expresión select-fromwhere
que se anida dentro de otra consulta. Un uso
común de subconsultas es llevar a cabo comprobaciones
sobre pertenencia a conjuntos, comparación de conjuntos
y cardinalidad de conjuntos. Estos usos se estudiarán
en los apartados siguientes.
96
not in comprueba la no pertenencia a un conjunto.
Como ejemplo considérese de nuevo la consulta
«Encontrar todos los clientes que tienen tanto un préstamo
como una cuenta en el banco». Anteriormente
escribimos esta consulta como la intersección de dos
conjuntos: el conjunto de los impositores del banco y
el conjunto de los prestatarios del banco. Sin embargo,
existe un enfoque alternativo consistente en encontrar
todos los tenedores de cuentas en el banco que son
miembros del conjunto de prestatarios. Claramente,
esta formulación genera el mismo resultado que la anterior,
pero obliga a formular la consulta usando la conectiva
in de SQL. Acontinuación, se van a obtener todos
los tenedores de cuentas formulando así la siguiente
subconsulta:
(select nombre-cliente
from impositor)
Acontinuación es necesario encontrar aquellos clientes
que son prestatarios del banco y que aparecen en la lista
de tenedores de cuenta, obtenida como resultado de
la subconsulta anterior. Esto se consigue anidando la
subconsulta en un select más externo. La consulta resultante
es la siguiente:
select distinct nombre-cliente
from prestatario
where nombre-cliente in (select nombre-cliente
from impositor)
Este ejemplo muestra que es posible escribir la misma
consulta de diversas formas en SQL. Esta flexibilidad
es de gran utilidad, puesto que permite al usuario
pensar en una consulta del modo que le parezca más
natural. Más adelante se verá que existe una gran cantidad
de redundancia en SQL.

4.7. VISTAS
Una vista en SQL se define utilizando la orden create
view. Para definir una vista se le debe dar un nombre y
se debe construir la consulta que genere dicha vista. La
forma de la orden create view es la siguiente:
create view v as <expresión de consulta>
donde <expresión de consulta> puede ser cualquier consulta
válida. El nombre de la vista se representa por v.
Nótese que la notación usada para la definición de una
vista en el álgebra relacional (véase Capítulo 3) se basa
en esta de SQL.
Como ejemplo considérese la vista consistente en los
nombres de sucursales y los nombres de los clientes que
tienen una cuenta o un préstamo en esa sucursal. Si se
denomina esta vista como todos-los-clientes se definirá
del modo siguiente:
create view todos-los-clientes as
(select nombre-sucursal, nombre-cliente
from impositor, cuenta
where impositor.número-cuenta
= cuenta.número-cuenta)
union
(select nombre-sucursal, nombre-cliente
from prestatario, préstamo
where prestatario.número-préstamo
= préstamo.número-préstamo)
Los nombres de los atributos de una vista se pueden
indicar explícitamente de la forma siguiente:
create view total-préstamos-sucursal
(nombre-sucursal, total-préstamos) as
select nombre-sucursal, sum (importe)
from préstamo
group by nombre-sucursal
La vista anterior contiene para cada sucursal la suma de
los importes de todos los préstamos de esa sucursal.
Como la expresión sum (importe) no tiene nombre, el
nombre del atributo se especifica explícitamente en la
definición de la vista.
Los nombres de vistas pueden aparecer en cualquier
lugar en el que pudiera aparecer un nombre de
relación. Usando la vista todos-los-clientes, se pueden
listar todos los clientes de la sucursal Navacerrada,
escribiendo
select nombre-cliente
from todos-los-clientes
where nombre-sucursal = ‘Navacerrada’

4.8. CONSULTAS COMPLEJAS
Las consultas complejas son a menudo difíciles o
imposibles de escribir como un único bloque SQL o
una unión, intersección o diferencia de bloques SQL
(un bloque SQL consiste en una única instrucción
select from where, posiblemente con cláusulas group
by y having). Aquí se estudian dos formas de componer
varios bloques SQL para expresar una consulta
compleja: las relaciones derivadas y la cláusula
with.
4.8.1. Relaciones derivadas
SQL permite el uso de una expresión de subconsulta en
la cláusula from. Si se usa una expresión de este tipo
se debe dar un nombre a la relación resultado y se pueden
renombrar los atributos usando la cláusula as. Por
ejemplo, considérese la subconsulta
(select nombre-sucursal, avg (saldo)
from cuenta
group by nombre-sucursal)
as media-sucursal (nombre-sucursal, saldo-medio)
Esta subconsulta produce una relación consistente en
los nombres de todas las sucursales y sus correspondientes
saldos de cuenta medios. El resultado de la subconsulta
recibe el nombre de media-sucursal y contiene
los atributos nombre-sucursal y saldo-medio.
Para ilustrar el uso de una expresión de subconsulta
en la cláusula from considérese la consulta «Obtener
el saldo medio de las cuentas de aquellas sucursales
donde dicho saldo medio sea superior a 1.200 €».
En el Apartado 4.4 se formulaba esta consulta utilizando
la cláusula having. Ahora se puede reescribir
dicha consulta sin usar esta cláusula de la siguiente
forma:
select nombre-sucursal, saldo-medio
from (select nombre-sucursal, avg (saldo)
from cuenta
group by nombre-sucursal)
as resultado (nombre-sucursal, saldo-medio)
where saldo-medio > 1200
4.9. MODIFICACIÓN DE LA BASE DE DATOS
Hasta ahora nos hemos limitado a la extracción de información
de una base de datos. A continuación se mostrará
cómo añadir, eliminar o cambiar información utilizando
SQL.
4.9.1. Borrado
Un borrado se expresa de igual modo que una consulta.
Se pueden borrar sólo tuplas completas, es decir, no
se pueden borrar valores de atributos concretos. Un
borrado se expresa en SQL del modo siguiente:
delete from r
where P
donde P representa un predicado y r representa una relación.
La declaración delete selecciona primero todas
las tuplas t en r para las que P (t) es cierto y a continuación
las borra de r. La cláusula where se puede omitir,
en cuyo caso se borran todas las tuplas de r.
Hay que señalar que una orden delete opera sólo
sobre una relación. Si se desea borrar tuplas de varias
relaciones, se deberá utilizar una orden delete por cada
relación. El predicado de la cláusula where puede ser
tan complicado como el where de cualquier cláusula
select, o tan simple como una cláusula where vacía. La
consulta
delete from préstamo
borra todas las tuplas de la relación préstamo (los sistemas
bien diseñados requerirán una confirmación del
usuario antes de ejecutar una consulta tan devastadora).
A continuación se muestran una serie de ejemplos
de borrados en SQL.
• Borrar todas las cuentas de la sucursal Navacerrada.
delete from cuenta
where nombre-sucursal = ‘Navacerrada’
• Borrar todos los préstamos en los que la cantidad esté
comprendida entre 1.300 € y 1.500 €.
delete from préstamo
where importe between 1300 and 1500
• Borrar las cuentas de todas las sucursales de Navacerrada.

OTROS LENGUAJES RELACIONALES
En el Capítulo 4 se ha descrito SQL, el lenguaje relacional de mayor influencia comercial.
En este capítulo se estudiarán dos lenguajes más: QBE y Datalog. A diferencia de
SQL, QBE es un lenguaje gráfico donde las consultas parecen tablas. QBE y sus variantes
se usan ampliamente en sistemas de bases de datos para computadoras personales. Datalog
tiene una sintaxis derivada del lenguaje Prolog. Aunque actualmente no se usa de forma comercial,
Datalog se ha utilizado en el desarrollo de diversos sistemas de bases de datos.
En este capítulo se presentan las constructoras y conceptos fundamentales en lugar de un
manual de usuario para estos lenguajes. Hay que tener presenta que las implementaciones individuales
de un lenguaje puede diferir en los detalles, o puede dar soporte sólo a un subconjunto
del lenguaje completo.
En este capítulo también se estudian interfaces de formularios y herramientas para generar
informes y analizar datos. Aunque no son lenguajes estrictamente hablando, forman la interfaz
principal a una base de datos para muchos usuarios. De hecho, la mayoría de usuarios en absoluto
ejecutan consultas explícitas con un lenguaje de consulta y acceden a los datos mediante
formularios, informes y otras herramientas de análisis de datos.
5.1. QUERY-BY-EXAMPLE
Query-by-Example (QBE, Consulta mediante ejemplos)
es el nombre tanto de un lenguaje de manipulación
de datos como el de un sistema de base de datos
que incluyó a este lenguaje. El sistema de bases de datos
QBE se desarrolló en el Centro de investigación T. J.
Watson de IBM, a principios de los años setenta y el
lenguaje de manipulación de datos QBE se usó más tarde
en QMF (Query Management Facility, mecanismo
de gestión de consultas), también de IBM. Actualmente,
muchos de los sistemas de bases de datos para computadoras
personales soportan variantes del lenguaje
QBE. En este apartado se considera sólo el lenguaje de
manipulación de datos. Tiene dos características distintivas:
1. A diferencia de muchos lenguajes de consulta y
de programación, QBE presenta una sintaxis bidimensional.
Las consultas parecen tablas. Una
consulta en un lenguaje unidimensional (como
SQL) se puede formular en una línea (posiblemente
larga). Un lenguaje bidimensional necesita
dos dimensiones para la formulación de consultas.
(Existe una versión unidimensional de
QBE, pero no se considerará en este estudio.)
2. Las consultas en QBE se expresan «mediante un
ejemplo». En lugar de incluir un procedimiento
para obtener la respuesta deseada, se usa un ejemplo
de qué es lo deseado. El sistema generaliza
este ejemplo para obtener la respuesta a la consulta.

5.2. DATALOG
Datalog es un lenguaje de consultas, no procedimental,
basado en el lenguaje de programación lógica Prolog.
Como se hace en el cálculo relacional, el usuario describe
la información deseada sin especificar un procedimiento
específico de obtención de dicha información.
La sintaxis de Datalog se asemeja a la de Prolog. Sin
embargo, el significado de los programas en Datalog se
define de una manera puramente declarativa, a diferencia
de la semántica más procedimental de Prolog. Datalog
simplifica la escritura de consultas simples y hace
más sencilla la optimización de consultas.
Un programa en Datalog consiste en un conjunto de
reglas. Antes de dar una definición formal de las reglas
de Datalog y su significado formal consideraremos unos
cuantos ejemplos. A continuación se muestra un ejemplo
de una regla Datalog para definir una relación de
vistas v1 que contiene los números de cuenta y los saldos
de las cuentas de la sucursal Navacerrada cuyo saldo
es superior a 700 €:
v1(C, S) :– cuenta (C, «Navacerrada», S), S > 700
Las reglas de Datalog definen vistas; la regla anterior
utiliza la relación cuenta y define la relación de vistas
v1. El símbolo :– se lee «si» y la coma que separa «cuenta
(C, »Navacerrada«, S)» de «S > 700» se lee «y». Intuitivamente,
la regla se entiende del siguiente modo:
para todo C,S
si (C, «Navacerrada», S) ∈ cuenta y S > 140000
entonces (C, S) ∈ v1

5.3. INTERFACES DE USUARIO Y HERRAMIENTAS
Aunque muchas personas interactúan con las bases de
datos, pocas usan un lenguaje de consulta para interactuar
directamente con un sistema de bases de datos. La
mayoría interactúan mediante uno de los siguientes
medios:
1. Los formularios e interfaces gráficas de usuario
permiten a los usuarios introducir valores
que completan las consultas predefinidas. El sistema
ejecuta las consultas y da formato apropiado
y muestra los resultados al usuario. Las
interfaces gráficas de usuario proporcionan una
forma fácil de interactuar con el sistema de bases
de datos.
2. Los generadores de informes permiten generar
informes predefinidos sobre los contenidos actuales
de la base de datos. Los analistas o gestores
examinan estos informes para tomar decisiones
de negocio.
3. Las herramientas de análisis de datos permiten
a los usuarios examinar interactivamente y
analizar los datos.
Hay que hacer notar que estas interfaces usan lenguajes
de consulta para comunicarse con los sistemas
de bases de datos.
En este apartado se proporciona una visión general
de los formularios, interfaces gráficas de usuario y
generadores de informes. El Capítulo 22 cubre las
herramientas de análisis de datos con más detalle. Por
desgracia no hay normas para las interfaces de usuario,
y cada sistema de base de datos proporciona usualmente
su propia interfaz de usuario. En este apartado
se describen los conceptos básicos, sin profundizar en
los detalles de ningún producto en concreto.
Las interfaces de formularios se usan ampliamente para
introducir y extraer datos en las bases de datos mediante
consultas predefinidas. Por ejemplo, los motores
World Wide Web proporcionan formularios que se usan
para introducir palabras clave. Al pulsar el botón
«Enviar» se provoca que el motor de búsqueda ejecute
una consulta usando las palabras clave introducidas y
que muestre el resultado al usuario.
Como otro ejemplo más orientado a las bases de
datos, es posible conectarse a un sistema de matrícula
de una universidad, donde se pide que se rellene un
código y una contraseña en un formulario. El sistema
usa esta información para comprobar la identidad, así
como para extraer de la base de datos información, como
el nombre y las asignaturas en las que el alumno se ha
matriculado, y mostrarla. Puede haber más vínculos en
la página Web que permitan buscar asignaturas y encontrar
más información acerca de las asignaturas como el
programa y el profesor.
Los exploradores Web compatibles con HTML constituyen
los formularios e interfaces gráficas de usuario
más ampliamente usados actualmente

5.4. RESTRICCIONES DE LOS DOMINIOS
Se ha visto que hay que asociar a cada atributo un dominio
de valores posibles. En el Capítulo 4 se vieron varios
tipos de dominios estándar, tales como los enteros, caracteres
y fecha/tiempo en SQL. La declaración de que un
atributo pertenezca a un determinado dominio actúa
como una restricción sobre los valores que puede tomar.
Las restricciones de los dominios son la forma más simple
de restricción de integridad. El sistema las verifica
fácilmente siempre que se introduce en la base de datos
un nuevo elemento de datos.
Es posible que varios atributos tengan el mismo
dominio. Por ejemplo, los atributos nombre-cliente y
nombre-empleado pueden tener el mismo dominio: el
conjunto de los nombres de persona. Sin embargo, los
dominios de saldo y de nombre de la sucursal deben
ser, ciertamente, diferentes. Quizá resulte menos evidente
si nombre-cliente y nombre-sucursal deben tener
el mismo dominio. En el nivel de implementación,
tanto los nombres de los clientes como los de las
sucursales son cadenas de caracteres. Sin embargo,
normalmente no se considerará que la consulta «Hallar
todos los clientes que tengan el nombre de una sucursal
» tenga sentido. Por tanto, si se considera la base
de datos desde el punto de vista teórico, en vez
de hacerlo desde el punto de vista físico, nombrecliente
y nombre-sucursal deben tener dominios diferentes.
De la discusión anterior se puede deducir que una
definición adecuada de las restricciones de los dominios
no sólo permite verificar los valores introducidos
en la base de datos, sino también examinar las
consultas para asegurarse de que tengan sentido las
comparaciones que hagan. El principio subyacente a
los dominios de los atributos es parecido al de los tipos
de las variables en los lenguajes de programación. Los
lenguajes de programación con tipos estrictos permiten
al compilador examinar el programa con mayor
detalle.
La cláusula create domain se puede usar para definir
nuevos dominios. Por ejemplo, las instrucciones:
create domain Euros numeric(12,2)
create domain Dólares numeric(12,2)
definen los dominios Euros y Dólares como números
decimales con un total de 12 dígitos, dos de los cuales
se sitúan después de la coma decimal. Un intento de
asignar un valor de tipo Dólares a una variable de tipo
Euros resultaría en un error sintáctico, aunque ambos
tengan el mismo tipo numérico. Tal asignación probablemente
es debida a un error del programador, en el
que este olvidó las diferencias de cambio. La declaración
de diferentes dominios para diferentes monedas
ayuda a detectar errores.
Los valores de un dominio pueden ser convertidos a
otro dominio. Si el atributo A de la relación r es de tipo
Euros, se puede convertir a Dólares escribiendo:
cast r.A as Dólares
En una aplicación real se multiplicaría r.A por el factor
de cambio antes de convertirlo a dólares. SQL también
proporciona las cláusulas drop domain y alter domain
para borrar o modificar dominios que se hayan declarado
anteriormente.
La cláusula check de SQL permite restringir los
dominios de maneras poderosas que no permiten la
mayor parte de los sistemas de tipos de los lenguajes de
programación. Concretamente, la cláusula check permite
al diseñador del esquema especificar un predicado
que debe satisfacer cualquier valor asignado a una
variable cuyo tipo sea el dominio. Por ejemplo, una cláusula
check puede asegurar que un dominio de sueldo
por hora sólo permita valores mayores que un valor especificado
(como puede ser el sueldo mínimo), tal y como
se muestra aquí:
create domain sueldo-por-hora numeric(5,2)
constraint comprobación-valor-sueldo
check(value ≥ 4.00)

5.5. INTEGRIDAD REFERENCIAL
A menudo se desea asegurar que un valor que aparece
en una relación para un conjunto de atributos determinado
aparezca también en otra relación para un cierto
conjunto de atributos. Esta condición se denomina integridad
referencial.
tal que tr [R ∩ S] = ts [R ∩ S]. Estas tuplas se denominan
colgantes. Las tuplas colgantes pueden ser aceptables en
función del conjunto de entidades o de relaciones que se
esté modelando. En el Apartado 3.5.2 se tomó en consideración
una forma de reunión modificada —la reunión
externa— para operar con las relaciones que contengan
tuplas colgantes. En este caso el motivo de preocupación
no son las consultas, sino el momento en que se desea permitir
que haya tuplas colgantes en la base de datos.
Supóngase que hay una tupla t1 en la relación cuenta
con t1[nombre-sucursal] = «As Pontes» pero que no
hay ninguna tupla de la relación sucursal para la sucursal
de As Pontes. Esta situación no es deseable. Se espera
que la relación sucursal muestre una relación de todas
las sucursales bancarias. Por tanto, la tupla t1 hará referencia
a una cuenta de una sucursal que no existe. Evidentemente,
es preferible tener una restricción de integridad
que prohíba las tuplas colgantes de este tipo.
Sin embargo, algunos casos de tuplas colgantes pueden
resultar convenientes. Supóngase que hay una tupla
t2 de la relación sucursal con t2[nombre-sucursal] =
«Gijón» pero que no hay ninguna tupla de la relación
cuenta para la sucursal de Gijón. En este caso hay una
sucursal que no tiene ninguna cuenta. Aunque esta situación
no es frecuente, puede producirse cuando se abre
una sucursal o cuando está a punto de cerrar. Por tanto,
no es deseable prohibir esta situación.
La distinción entre estos dos ejemplos se basa en dos
hechos:
• El atributo nombre-sucursal de Esquema-cuenta
es una clave externa que hace referencia a la clave
primaria de Esquema-sucursal.
• El atributo nombre-sucursal de Esquema-sucursal
no es una clave externa.
(Recuérdese del Apartado 3.1.3 que una clave externa
es un conjunto de atributos del esquema de una relación
que forma la clave primaria de otro esquema.)
En el ejemplo de As Pontes la tupla t1 de cuenta tiene
un valor en la clave externa nombre-sucursal que no
aparece en sucursal. En el ejemplo de la sucursal de
Gijón, la tupla t2 de sucursal tiene un valor de nombresucursal
que no aparece en cuenta, pero nombre-sucursal
no es una clave externa. Por tanto, la distinción entre
los dos ejemplos de tuplas colgantes es la presencia de
una clave externa.
Sean r1(R1) y r2(R2) dos relaciones con las claves primarias
K1 y K2, respectivamente. Se dice que un subconjunto
α de R2 es una clave externa que hace referencia
a K1 de la relación r1 si se exige que para cada t2
de r2 haya una tupla t1 de r1 tal que t1[K1] = t2[α]. Las
exigencias de este tipo se denominan restricciones de
integridad referencial o dependencia de subconjunto.
El último término se debe a que esta última restricción
de integridad referencial puede escribirse como Πα
(r2) ⊆ΠK1 (r1). Obsérvese que, para que una restricción
de integridad referencial tenga sentido, α debe ser igual
a K1, o bien α y K1 deben ser conjuntos compatibles de
atributos.
Las restricciones de integridad referencial aparecen con
frecuencia. Si se obtiene el esquema de la base de datos
relacional creando tablas a partir de los diagramas E-R,
tal y como se vio en el Capítulo 2, cada relación que proceda
de un conjunto de relaciones tendrá restricciones
de integridad referencial. En la Figura 6.1 se muestra un
conjunto n-ario de relaciones R, que relaciona los conjuntos
de entidades E1, E2, …, En. Ki denota la clave primaria
de Ei. Los atributos del esquema de la relación del
conjunto de relaciones R incluyen K1 ∪ K2 ∪ … ∪ Kn.
Cada Ki del esquema de R es una clave externa que lleva
a una restricción de integridad referencial.
Otra fuente de restricciones de integridad referencial
son los conjuntos de entidades débiles. Recuérdese del
Capítulo 2 que el esquema de la relación de un conjunto
de entidades débiles debe incluir la clave primaria
del conjunto de entidades del que este depende. Por tanto,
el esquema de la relación de cada conjunto de entidades
débiles incluye una clave externa que lleva a una
restricción de integridad referencial.

AUTOEVALUACIÓN
INTRODUCCIÓN
1.- ¿Cuales son 8 las aplicaciones mas representantes de una base de datos? A) Banca, telecomunicaciones, aplicaciones, sistemas, datos B) producción curso, movimiento y producto
C) banca, lineas aéreas, universidades, telecomunicaciones, finanzas, ventas, producción y recurso
D) área, unidades, banca, aplicaciones, programación
2.- ¿ En que año aumento significativamente el acceso de usuario de una base de datos?
A) 1989
B) 1990
C) 1880
D) 1989
3.- ¿Cuales son los estándares de interfaces del lenguaje para la interacción entre el cliente y el servicio?
A) ODBC y JDBC
B) HTML y ODBC
B) 1990
C) 1880
D) 1989
3.- ¿Cuales son los estándares de interfaces del lenguaje para la interacción entre el cliente y el servicio?
B) HTML y ODBC
C) JDBC y BT
D) JBDC y OBCD
4.-¿ Menciona las siglas "Un Lenguaje de manipulación de datos"...?
A) HTML
B) LMD
C) LDM
D) Ninguna de las anteriores
D) JBDC y OBCD
4.-¿ Menciona las siglas "Un Lenguaje de manipulación de datos"...?
B) LMD
C) LDM
D) Ninguna de las anteriores
MODELO
ENTIDAD-RELACIÓN
1.-¿A que puede
definir ciertas restricciones a las que los contenidos de la base de datos?
A) esquema
B) formulario
C) Un esquema de desarrollo E-R
D) etiquetas
2.- Cuales son los atributos del conjunto de entidades del cliente que son...?
A) id-norma cliente-nombre numero-persona
B) nombre-id,cuidad-persona, cliente-persona
C) datos-id,calle-cuidad,cliente-id
D) id-cliente,nombre-cliente,calle-cliente y cuidad-cliente
3.-¿Cual es el numero mencionado que identifique únicamente a una persona el particular?
A) 67.789.901
B) 59.423.678
C) 20.387.348
D) 67.867.096
4.- ¿Que componente debe tener un diagrama?
A) lineas, círculos, diagonales, paréntesis, lineas rectas
B) rectángulo, elipses, lineas, elipses dobles, elipses discontinuas,lineas dobles y rectángulos dobles
C) rectángulo, elipses,elipses dobles, elipses discontinuas,lineas
D) ninguna de las anteriores
3.-¿Cual es el numero mencionado que identifique únicamente a una persona el particular?
A) 67.789.901
B) 59.423.678
C) 20.387.348
D) 67.867.096
4.- ¿Que componente debe tener un diagrama?
A) lineas, círculos, diagonales, paréntesis, lineas rectas
B) rectángulo, elipses, lineas, elipses dobles, elipses discontinuas,lineas dobles y rectángulos dobles
C) rectángulo, elipses,elipses dobles, elipses discontinuas,lineas
D) ninguna de las anteriores
EL modelo relacional
1.- ¿Una base de datos esta compuesta por...?
A) archivos
B) carpetas
C) tablas y formularios
D) información y datos
2.- ¿Describe una relación descrita en el álgebra relacionada mediante?
A) Πnombre-cliente,
número-préstamo, nombre-sucursal
B) nombre-persona, numero,cuenta
C) nombre-cliente, numero,cuenta,nombre-sucursal
D) cliente-nombre,prestamo-numero, sucursal,nombre
3.-¿Cuales son las formas del calculo relacionada con el calculo?
A) dominio y temas
B) variables y dominio de atributos
C) control y almacén
D) subtemas y temas
4.-¿Cual es la materia que se relaciona estrechamente con los dominios?
A) matemáticas
B) física
C) español
D) calculo
SQL
1.-¿ Cual es el lenguaje que maneja una base de datos?
A) SQL
B) C + +
C) HTML
D) DFD
2.-¿ En que año originalmente se denomino SQL?
A) 1873
B) 1783
C)1970
D) 1957
3.-¿ Cual es el lenguaje de definición de datos?
A) LFG
B) LDD
C) LDF
D) DLL
4.-¿ Cuales son las 3 clausulas de SQL?
A) selec, where y else
B) clip, where y are
C) from, locatey in
D) select, from y where
OTROS LENGUAJES RELACIONALES
1.-¿Cuales son los 2 lenguajes en el tema "otras lenguajes relacionales"?
A) SQL Y C ++
B) QBE y Datalog
C) HTML Y DFD
D) SQL Y QBE
2.-¿menciona las siglas de Query- by- Example?
A) SQL
B) QSE
C) QEB
D) QBE
3.-Cual es condición se denomina integridad referencia
A) tr [R ∩ S] = ts [R ∩ S]
B)TR r. s
C) R.s
D) ninguna de las anteriores
4.-¿Cuales son las 2 distinciones del lenguaje?
A) objetovo y duda
B) atributo y atributo nombre -sucursal
C) notas y atributos
D) nombre y atributo
RESPUESTAS
INTRODUCCIÓN
C
B
A
B
MODELO ENTIDAD-RELACIÓN
C
D
A
B
EL modelo relacional
C
A
B
D
SQL
A
C
B
D
OTROS LENGUAJES RELACIONALES
B
D
A
B

Hola soy Maria Jose :)
ResponderBorrarTu sección de este blog es buena, sera de utilidad para quien necesite ayuda sobre tu materia (Bases de datos avanzadas).
Te recomiendo que enumeres bien los temas y que así como los enumeres después los expliques, justifica la letra, resume mas la información.
De ante mano "FELICIDADES" por tu trabajo, tu calificación seria de 8.
Hola mi nombre es iridian, tu blog de bases de datos avanzadas esta muy bien,solo una observacion en los temas enumerarlos bien y una mejor explicacion del mismo.Mi calificacion seria un 8.
ResponderBorrarEste comentario ha sido eliminado por el autor.
ResponderBorrarEste comentario ha sido eliminado por el autor.
ResponderBorrarEste comentario ha sido eliminado por el autor.
ResponderBorrarHola soy "el Julio"
ResponderBorrartu sección del blog sobre la materia de base de datos avanzadas es buena, solo acomoda la evaluación para que sea mas entendible
tu calificación es 8
Este comentario ha sido eliminado por el autor.
ResponderBorrarHola mi nombre es Juan Carlos Hernández Rivera
ResponderBorrarBueno es entendible pero falta que pongas otro tipo de letra para que llames mas la atención las preguntas formulas mejor y dales una mejor estructura en general felicidades buen trabajo mi calificación 8
Hola soy Marco Valdez. (el mayk)
ResponderBorrarTu sección del blog sobre la materia de Base de datos avanzadas esta muy bien hecha, simplemente estructura ,mejor tu evaluación
Calificación: 8.2
Hola mi nombre es Elisa.
ResponderBorrarBuen trabajo solo que no es muy entendible porque no están bien explicados los temas, las preguntas no tienen mucha coherencia, la letra tiene que ser del mismo tipo y tamaño al igual que las imágenes.
Tu calificación es 7.5.
Juan Alberto Vazquez
ResponderBorrareste blog esta muy bien solo falta cambiar el tipo de letra para que tenga buena presentacion...
Calificacion 8
Rosa isela jimenez
ResponderBorrartu blog esta bien solo te recomiendo que justifiques los textos y el tamaño de letra...
calificacion de 7.5
hola soy fabián me gusto el bloc esta bien solo acomoda un poco el texto calificacion 10
ResponderBorrarHola soy Wendi.
ResponderBorrarMe gusto mucho tu blog! solo que tienes demasiada información trata de organizar mejor y darle una mejor estructura , tu calificación es 8.5.
Hola, soy Pedro.
ResponderBorrarFalta de estructura, falta de formato, etc...
Mi calificación: 7
Hola, soy Alondra.
ResponderBorrarMuy buen blog, demasiada información. Tal vez sea de mucha mas ayuda para las personas que necesiten saber de tu materia.
Calificación: 8.5
Gabriela García.
ResponderBorrarEs demasiada información y eso es bueno, pero creo que es mejor sólo lo que es de utilidad. Con demasiada información creo que debiste de haber puesto muchas más imágenes ya que se ve algo pobre.
El texto en mi punto de vista tiene mala presentación ya que no esta justificado.
Calificación: 7.5
Leonardo Sierra Mendoza.
ResponderBorrarEs mucha información y creo que no toda sirve, pero aún así buen trabajo.
Calificación: 8
am, pues esta bien tu blog, tienes buenas imágenes y buena informacion.
ResponderBorrarcalificación: 7
Ricardo Casillas M
ResponderBorrarBien solo que le falta un poco de organizacion
calificacion:9.5
juan fernando ruiz r
ResponderBorrarmuy bien , mucha informacion muy util
calificacion:9.6
Eyy!!! hola!! soy Luis Fernando Pérez Aguilera (sany)..... increíble blog muy útil me encanto, buen fondo excelente acomodo de informacion, se que tu blog sera de mucha utilidad para quien necesite utilzarlo .... chan chan chan chaaaaaan!!!.... tu calificacion es.... : 10
ResponderBorrarViridiana Ceron.
ResponderBorrarTu blog es bueno, solo falta un poco de organizacion.
Calificacion: 9.5
Hola soy Fernando (Tocino)
ResponderBorrarmuy buena informacion
Calificacion 9 :)